kubernetes的设计架构
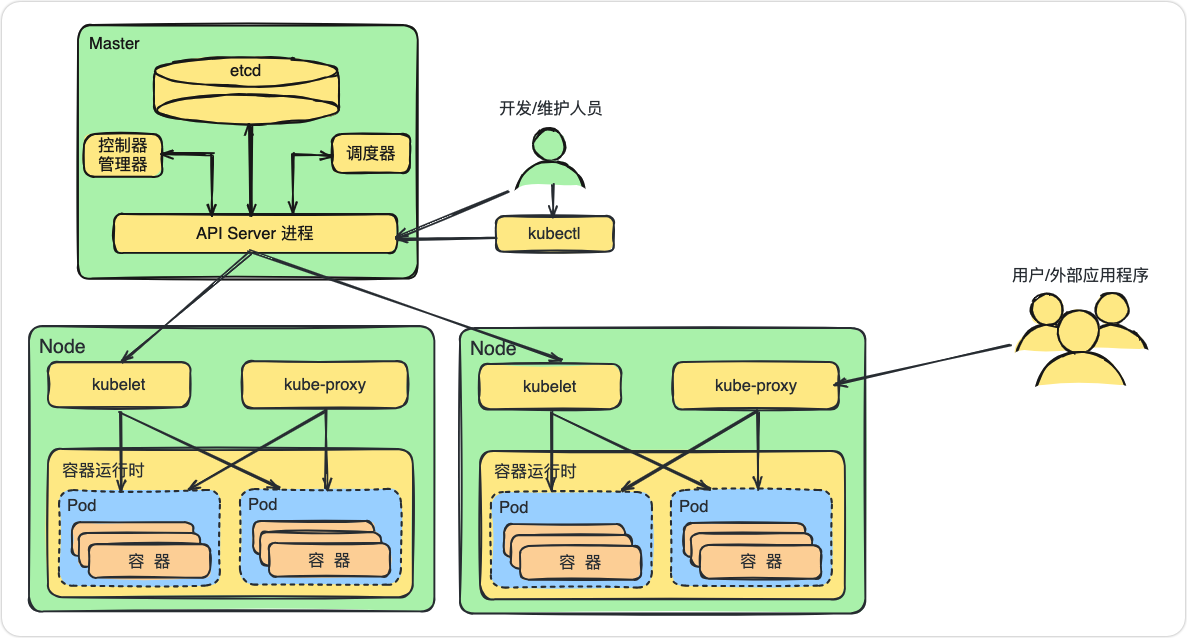
在kubernetes集群中,有master和node这两种角色。master管理node,node管理容器。
master主要负责整个集群的管理控制 相当于整个kubernetes集群的首脑。它用于监控、编排、调度集群中的各个工作节点。通常master会占用一台独立的服务器,基于高可用原因,也有可能是多台。
node则是kubernetes集群中各个工作节点。node由master管理,提供运行容器所需的各种环境,对容器进行实际的控制,而这些容器会提供实际的应用服务。
kubernetes的整体架构如图所示。
 master
的组成如图所示。
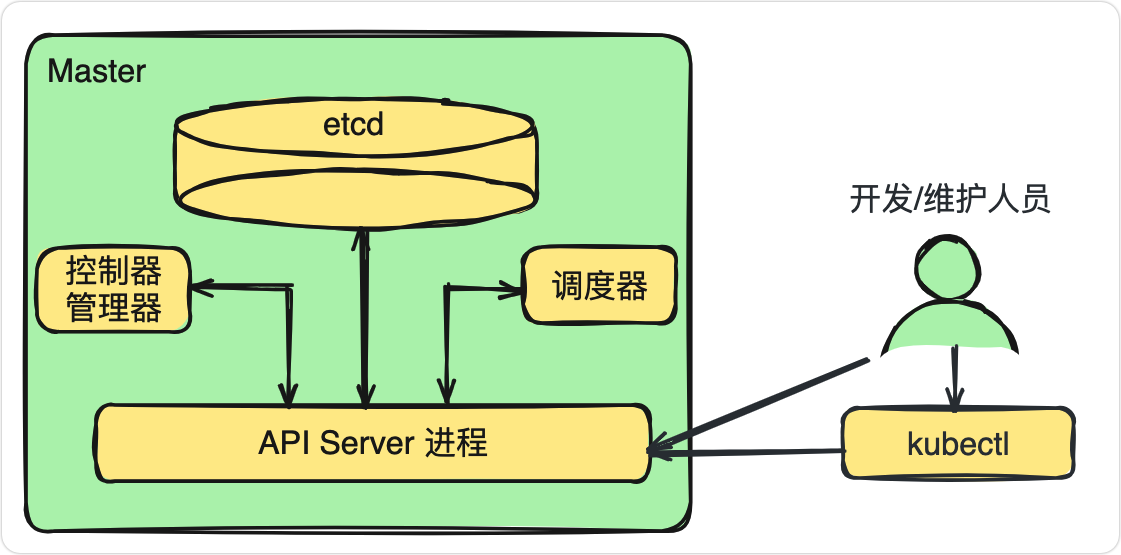 API Server进API Server(kube-apiserver)进程中各类资源对象提供了增删改查等http rest接口。对于资源的任何操作,都需要经过API Server进程来处理。除此之外,API Server进程还提供了一系列认证授权机制。
对于用户来说,访问API Server进程有三种方式。
-
直接通过REST Ruqest的方式来访问。
-
通过官方提供的客户端库文件来访问,本质上,通过编程方式,转换为对API Server进程的REST API调用。
-
通过命令行工具kubectl客户端来访问。kubectl客户端将命令行转换为对API Server进程的REST API调用。
后续演示中使用的各种命令均是使用kubectl客户端来调用API Server进程的。
etcd
etcd项目是一种轻量级的分布式键值存储,由CoreOS团队开发,可以在单台master服务器上配置,也可以配置到多台服务器。
可以将etcd理解为kubernetes的“数据库”,用于保存集群中所有的配置和各个对象的状态信息。
只有API Server进程才能直接访问和操作etcd。
调度器
调度器(kube-scheduler)是pod资源的调度器。它用于监听最近创建但未分配node的pod资源,会为pod自动分配相应的node。
调度器在调度时会考虑各种因素,包括资源需求、硬件/软件/指定限制条件、内部负载情况等。
调度器所执行的各项操作均是基于API Server进程的。如调度器会通过API Server进程的watch接口监听新建的pod,并搜索所有满足的node列表,再执行pod调度逻辑。调度成功后会将pod绑定到目标node上。
控制器管理器(kube-controller-manager)
kubernetes集群的大部分功能是由控制器执行的。理论上,以下每种控制器都是一个独立的进程,为了降低复杂度,它们都被编译、合并到单个文件中,并在单个进程中运行。
-
node控制器:负责在node出现故障时做出响应
-
replication控制器:负责对系统中的每个replicationcontroller对象维护正确数量的pod。
-
endpoint控制器:负责生成和维护所有endpoint对象的控制器。endpoint控制器用于监听service和对应的pod副本的变化。
-
Serveraccount及token控制器:为新的命名空间创建默认账户和API访问令牌。
kube-controller-manager所执行的各项操作也是基于API Server进程的。例如,node控制器会通过API Server 进程提供的watch接口,实时监控node的信息并进行相应的处理。
node
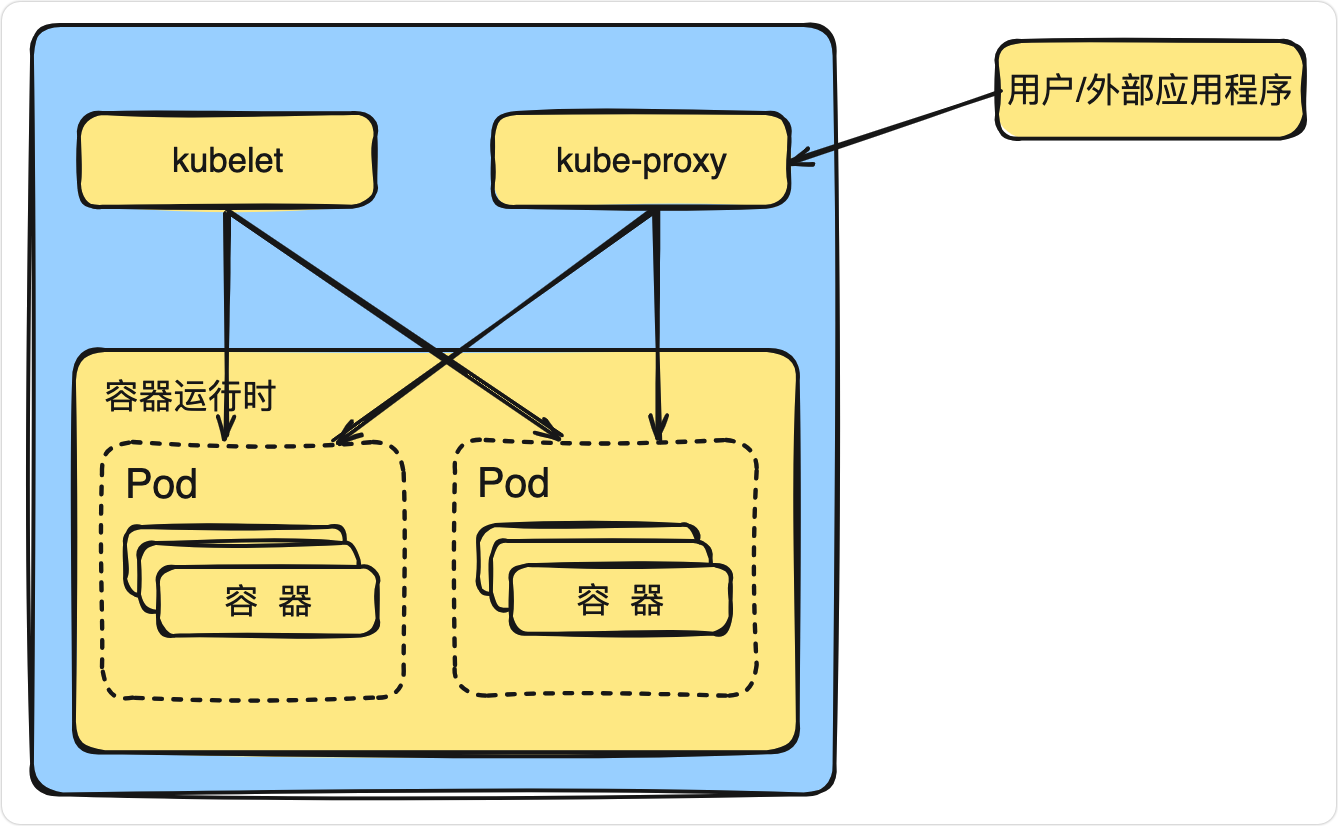
node的组成如下图所示。node主要由3个部分组成,分别是kubelet、kube-proxy和容器运行时(container runtime)。
kubelet
kubelet是在每个node上都运行的主要代理进程。kubelet以podspec为单位来运行任务,podspec是一种描述pod的yaml或json对象。kubelet会运行由各种机制提供(主要通过API Server)的一系列podspec,并确保这些podspec中描述的容器健康运行。不是kubernetes创建的容器将不属于kubelet的管理范围。kubelet负责维护融洽的生命周期,同时也负责存储卷(volume)等资源的管理。
每个node上的kubelet会定期调用master节点上API Server进程的rest接口,报告自身状态。API Server进程接收这些信息后,会将node的状态信息更新到etcd中。hubelet也通过API Server进程的watch接口监听pod信息,从而对node上的pod进行管理。
kube-proxy
kube-proxy主要用于管理service的访问入口,包括从集群内的其他pod到service的访问,以及从集群外访问service。
容器运行时
容器运行时是负责运行容器的软件。kubernetes支持多种运行时,包括docker、containerd、cri-o、rktlet以及任何基于kubernetes CRI(容器运行时接口)的实现。
组件间的基本交互流程
接下来简要描述各个组件之间是如何交互的。以pod的创建为例,当使用kubectl创建pod,会相继发生以下事件。
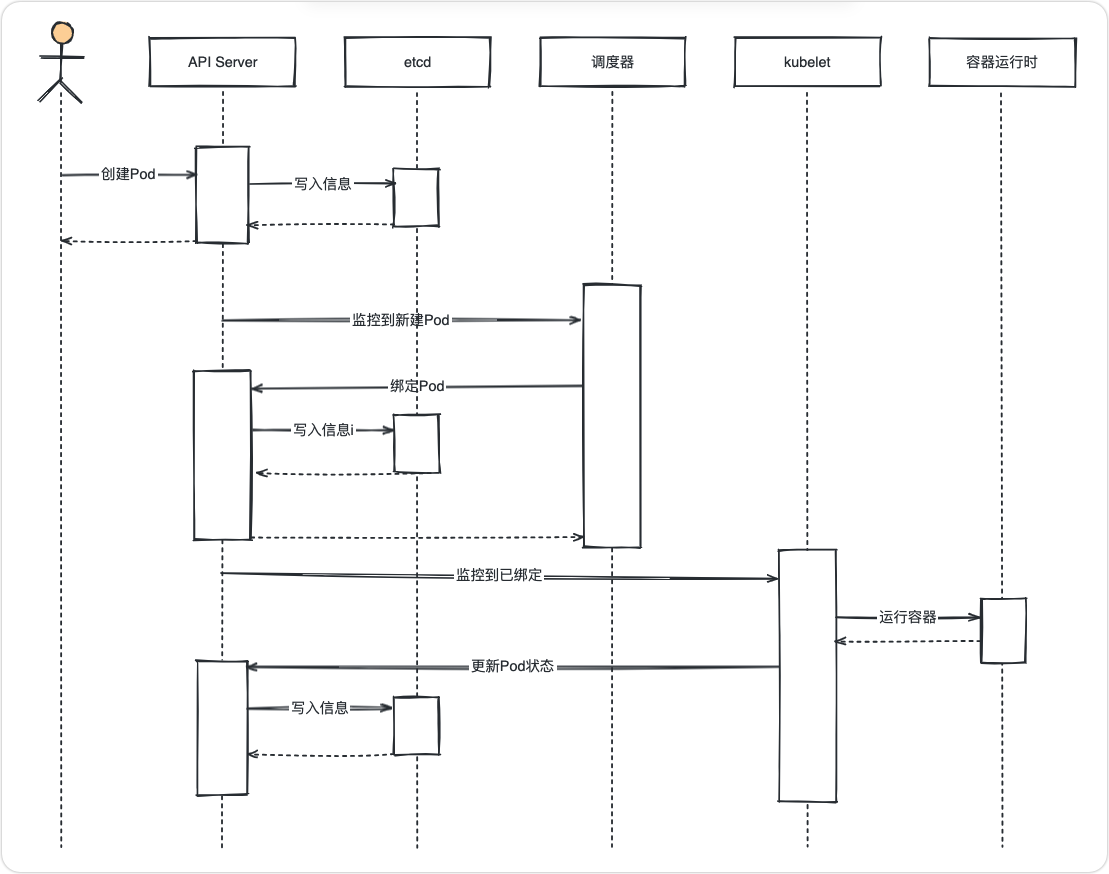
具体发生的事件如下:
(1) kubectl命令将转换为对API Server的调用。
(2) API Server验证请求并将其保存到etcd中。
(3) etcd通知API Server。
(4) API Server调用调度器。
(5) 调度器决定在哪个节点运行pod,并将其返回给API Server。
(6) API Server将对应节点保存到etcd中。
(7) etcd通知API Server。
(8) API Server在相应的节点中调用kubelet。
(9) kubelet与容器运行时API发生交互,与容器守护进程通信以创建容器。
(10) kubelet将pod状态更新到API Server中。
(11) API Server把最新的状态保存到etcd中。
kubernetes的核心对象
虽然应用程序部署的底层机制是容器,但kubernetes在容器接口上使用了额外的抽象层,以支持弹性伸缩和生命周期的功能。用户并不是直接管理容器的,而是定义由kubernetes对象模型提供的各种基本类型的实例,并与这些实例进行交互,如图所示。
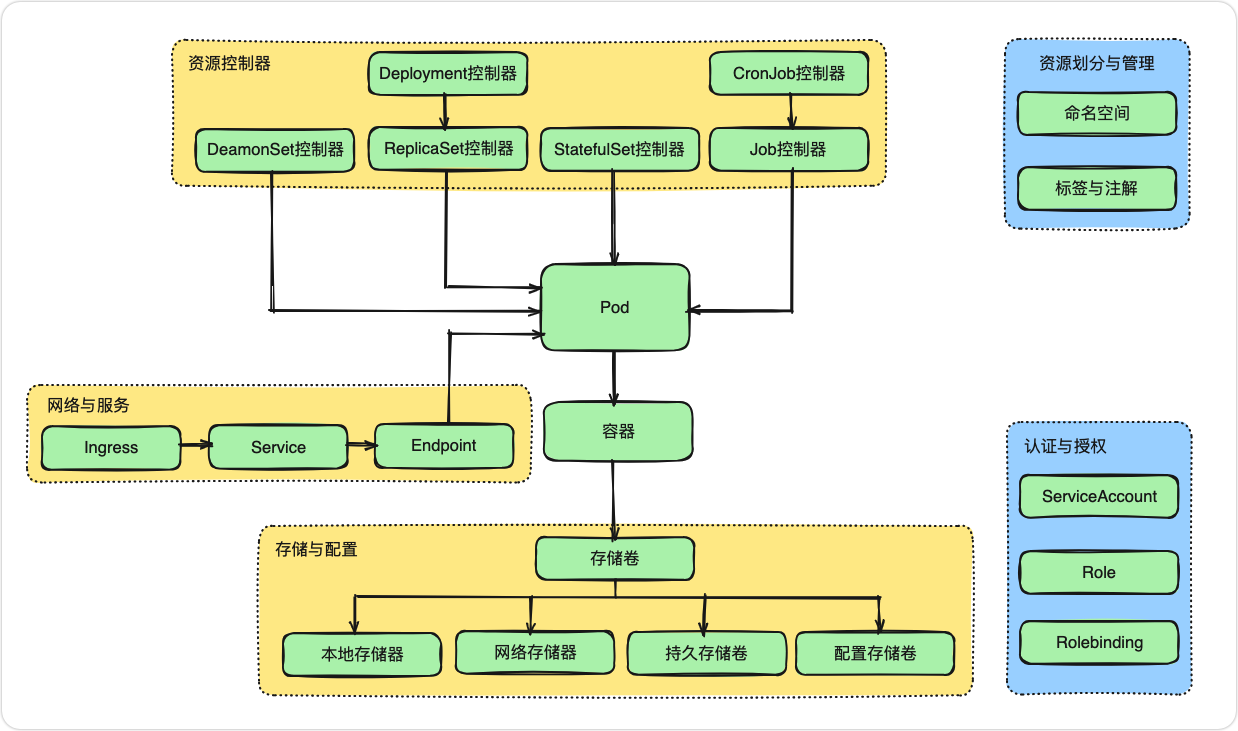
接下来将介绍一些主要的资源对象。
pod
pod是kubernetes处理的最基本单元。容器本身并不会直接分配到主机上,而是会封装到名为pod的对象中。
pod通常表示单个应用程序,由一个或多个关系紧密的容器构成,如图所示,这些容器拥有同样的生命周期,作为一个整体一起编排到node上。这些容器共享环境、存储卷、和IP空间。尽管pod基于一个或多个容器,但应将pod视作单一的整体、单独的应用程序。kubernetes以pod为最小单位进行调度、伸缩并共享资源、管理生命周期。
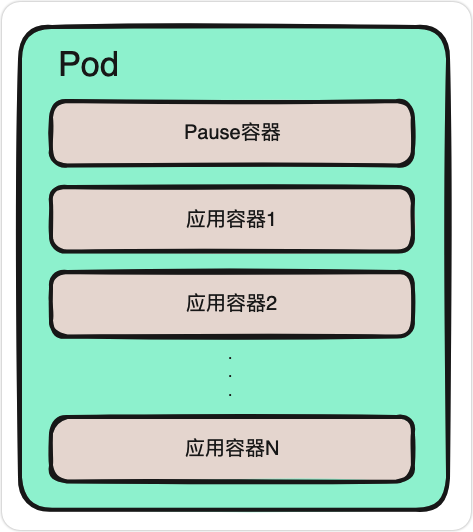
一般来说,用户不应自行管理pod,因为pod并没有提供应用程序通常会用到的一些特性,如复杂的生命周期管理及动态伸缩。建议用户使用将pod或pod模板作为基本组件的更高级别对象,这些对象会拥有更多的特性。
控制器
一般来说,用户不会直接创建pod,而是创建控制器,让控制器来管理pod。在控制器中定义pod的部署方式(如有多少个副本、需要在哪种node上运行等),根据不同的业务场景,kubernetes提供了多种控制器,接下来将分别介绍。
replicationcontroller和replicaset控制器
在使用kubernetes时,通常要管理的是由多个相同pod组成的pod集合,而不是单个pod。例如,replicationcontroller或者replicaset控制器基于pod模板进行创建,能够很好地支持水平伸缩。
ReplicationController可定义Pod模板,并可以设置相应控制参数以实现水平伸缩,以调节正在运行的相同的Pod数。这是在Kubernetes中调节负载并增强可用性的简单方式。 ReplicationController能根据需要自动创建新的Pod,在 ReplicationController的配置中拥有和Pod定义非常相似的模板。
ReplicationController负责保障在集群中部署的Pod数量与配置中的Pod数量一致。如果Pod或主机出现故障, ReplicationController会自动启用新的Pod进行补充。如果 ReplicationController配置中的副本数量发生改变,则会启动或终止一些Pod来匹配设定好的数量。 ReplicationController还可以执行滚动更新,将一组Pod逐个切换到最新版本,从而最大限度地减少对应用程序可用性的影响。
ReplicationSet控制器可以看作 ReplicationController的另一种版本,其Pod识别功能使它在Pod管理上更具灵活性。由于ReplicaSet控制器具有副本筛选功能,因此ReplicationSet控制器才有逐渐替代 ReplicationController的趋势,但ReplicationSet控制器无法实现滚动更新,无法想 ReplicationController那样在后端轮流切换到最新版本。
与Pod一样, ReplicationController和ReplicationSet控制器都是很少直接使用的对象。虽然它们都是基于Pod而设计的,增加了水平伸缩功能,提高了可靠性,但它们缺少一些在其他负责对象中具有的更细粒度的生命周期管理功能。
Deployment控制器
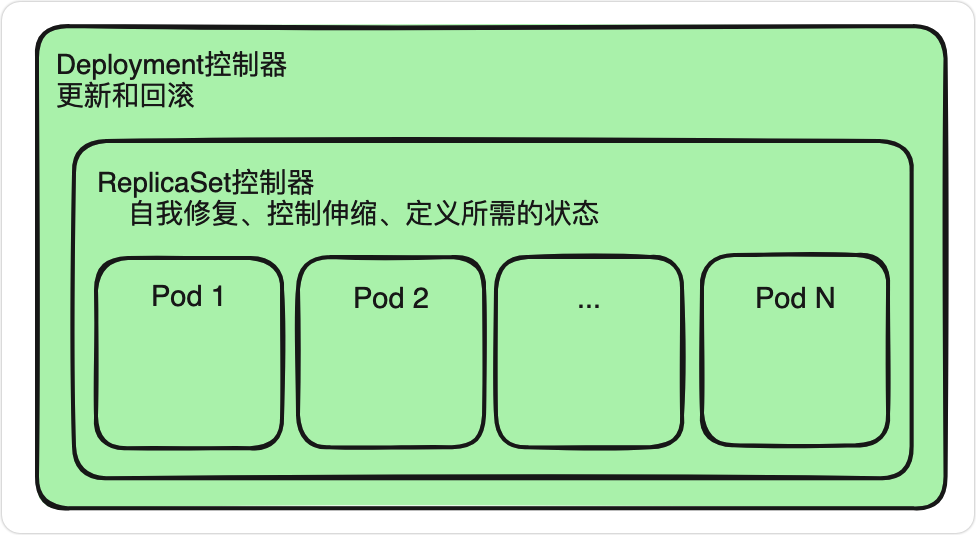
Deployment控制器可能是最常用的工作负载对象之一。Deployment控制器以及ReplicaSet控制器为基础,是更高级的概念,增加了更灵活的生命周期管理功能。
虽然Deployment控制器是基于ReplicaSet控制器的,但仍有部分功能和 ReplicationController相似,Deployment控制器解决了之前在滚动更新上存在的诸多难点。如果用 ReplicationController来更新应用程序,用户需要提交一个新的 ReplicationController计划,以替换当前的控制器。因此,对于历史记录跟踪、更新出现网络故障时的回复以及回滚错误修改等任务, ReplicationController要么做起来非常艰难,要么需要用户自理。
Deployment控制器是一种高级对象,旨在简化Pod的生命周期管理。只要简单更改Deployment控制器的配置文件,Kubernetes就会自动调节ReplicaSet控制器,管理应用程序不同版本之间的切换,还可以实现自动维护时间历史记录及自动撤销功能,如下所示。正是由于这些强大的功能,Deployment控制器可能是使用频率最高的对象。
StatefulSet控制器
StatefulSet控制器是一种提供了排序和唯一性保证的特殊Pod控制器。当有与部署顺序、持久数据或固定网络等相关的特殊需求时,可以使用StatefulSet控制器来进行更细粒度的控制。StatefulSet控制器主要用于有状态的应用,例如,StatefulSet控制器通常与面向书的应用程序(比如数据库)关联。及时StatefulSet控制器被重新分配到一个新的节点上,还需要访问通一个存储卷。
StatefulSet控制器为每个Pod创建唯一的、基于数字的名称,从而提供稳定的网络标识符。即使要将Pod庄毅到另一个节点,该名称也将持续存在。同样,当需要重新调度时,可以通过Pod转移持久性数据卷。即使删除了Pod,这些卷也依然存在,以防止数据意外丢失。
每当部署或进行伸缩调节时,StatefulSet控制器会根据名称中的标识符执行操作,这对执行顺序有了更大的可预测性和控制能力,它在某些情况下很有用。
Deployment控制器下的每一个Pod都毫无区别地提供服务,但StatefulSet控制器的Pod则不痛。虽然各个Pod的定义是一样的,但是因为其数据的不同,所以提供的服务是有差异的。比如分布式存储系统适合使用StatefulSet控制器,由Pod A 存储一部分数据并提供相关服务,Pod B又存储另一部分数据并提供相关服务。又比如有些服务会临时保存客户请求的数据,例如,使用服务端会话方式存放部分信息的业务网站,由于会话的不同,Pod A和Pod B能提供的服务也不尽相同,这种场景也适合StatefulSet控制器。
DaemonSet控制器
DaemonSet控制器是另一种特殊的Pod控制器,它会在集群的各个节点上云霄单一的Pod副本。DaemonSet控制器非常适合部署那些为节点本身提供服务或执行维护的Pod。
例如,日志收集和转发、监控以及运行以增加节点本身功能为目的的服务,常设置为DaemonSet控制器。因为DaemonSet控制器通常是用于提供基本服务的,并且每个节点都需要,所以它们可以绕过某些用于阻止控制器将Pod分配给某些主机的调度限制。因为DaemonSet控制器独特的职责,原本Master服务器不可用于常规的pod调度,但DaemonSet控制器可以越过基于Pod的限制,确保基础服务的运行。
Job控制器和CronJob控制器
上述的各类工作负责对象都是长期运行的,拥有服务级的生命周期。Kubernetes中还有一种叫做Job控制器的工作负载对象,它基于特定任务而运行。当运行任务的容器完成工作后,Job就会成功退出。如果需要执行一次性的任务,而费提供连续的服务,Job控制器非常适合。
CronJob控制器其实在Job控制器的基础上增加了时间调度,可以在给定的时间点运行一个任务,也可以周期性地在给定时间点运行一个任务。CronJob控制器实际上和Linux系统中的Crontab控制器非常类似。
服务与存储
Service组件和Ingress
在Kubernetes中,Service是内部负责均衡器中的一种组件,会将相同功能的Pod在逻辑上组合到一起,让他们表现的如同一个单一的实体。
之前介绍的各个工作负载对象只保证了支撑服务的微服务Pod的数量,但是没有解决如何访问这些服务的问题。Pod只是一个运行的应用示例,随时可能在一个节点上停止,并在另一个节点使用新的IP地址启动新的Pod,因此Pod根本无法以固定的IP地址和端口号提供服务。
通过Service组件可以发布服务,可以跟踪并路由到所有指定类型的后端容器。内部使用者只需要知道Service组件提供的稳定断电即可进行访问。另外,Service组件抽象可以根据需要来伸缩或替换后端的工作单元,无论Service组件具体路由到哪个Pod,其IP地址都保持稳定。通过Service组件,可以轻松获得服务发现能力,如下图所示:
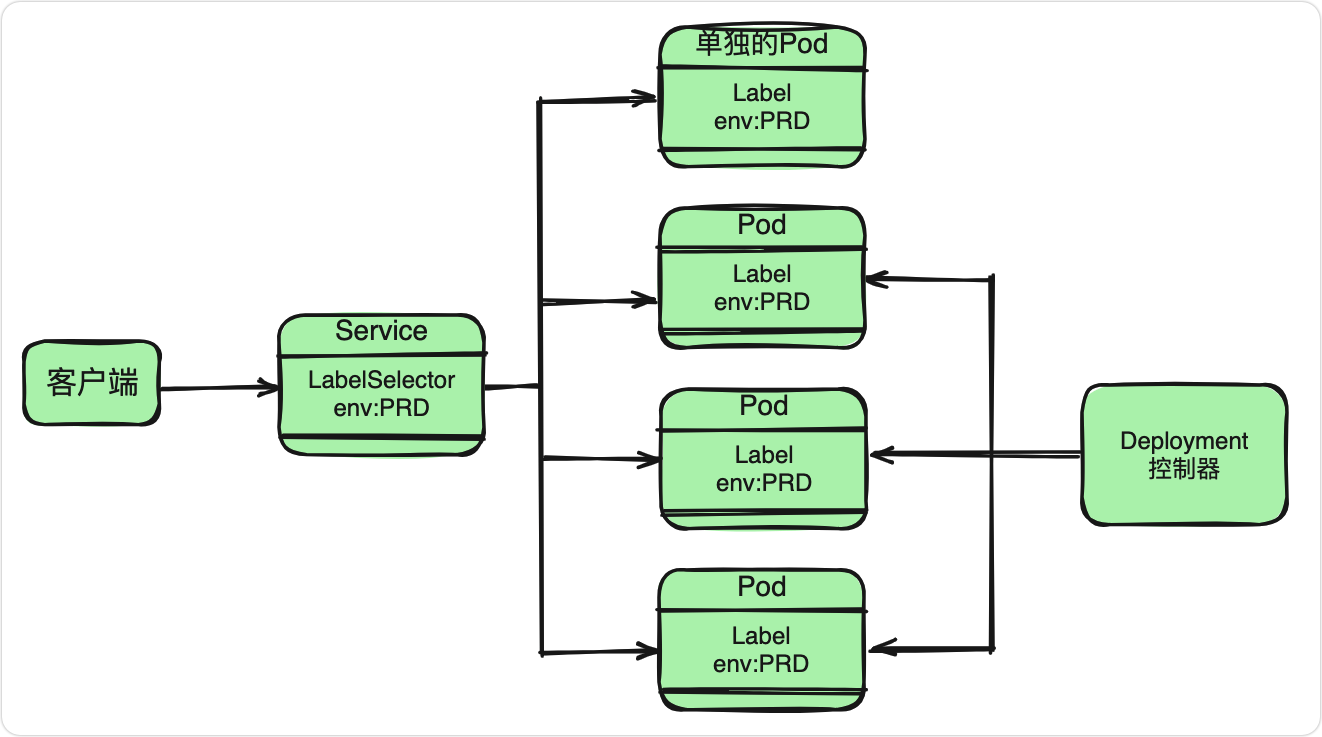
每当需要给另一个应用程序或外部用户提供某些Pod的访问权限时,就可以配置一个Service组件。比如,假设需要从外网访问Pod上运行的应用程序,就需要提供必要的Service组件抽象,使应用程序能访问数据库Pod。
虽然在默认情况下只有Kubernetes集群内的机器(Master和Node)以及Pod应用可以访问Service组件,但通过某些策略,可以在集群之外使用Service组件。例如,通过配置Nodeport,可以在各个节点的外部网络接口上打开一个静态端口。该端口的流量将会通过内部集群IP服务自动路由到响应的Pod。
还可以通过Ingress来整合Service组件。Ingress并不是某种服务类型,可以充当多个Service组件的统一入口。Ingress支持将路由规则合并到单个资源中,可以通过同一域名或IP地址下不同的路径来访问不通的Service组件,如图所示,实现在同一域名或IP地址下发布多个服务。
存储卷和持久存储卷
在容器化环境中,如何可靠地共享数据并保证这些数据在容器重启的间隙始终是可用的,一直都是一个挑战。容器运行时通常会提供一些机制来将存储附加到容器上,这类容器的存留时间超过其他容器的生命周期,但实现起来通常缺乏灵活性。
为了解决这些问题,Kubernetes定义了自己的存储卷(volume)抽象,允许Pod中的所有容器共享数据,并在Pod终止之前一直保持可用,如图所示。这意味着紧密耦合的Pod可以轻松共享文件而不需要复杂的外部机制,Pod中的容器故障不会影响对共享文件的访问。Pod终止后,共享的存储卷会被销毁,因此对于真正需要持久化的数据来说,这并非一个好的解决方案。
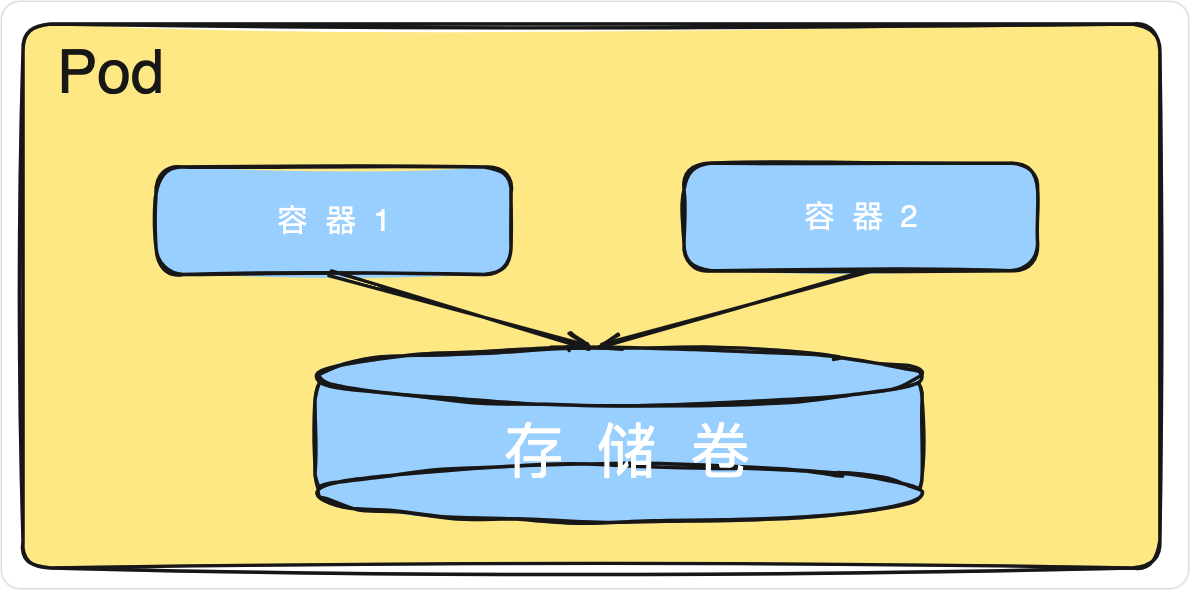
持久存储卷(persistent volume)是一种更健壮的抽象机制,不依赖于Pod的生命周期。持久存储卷允许管理员为集群配置存储资源,用户可以为正在运行的Pod请求和声明存储资源。带有持久存储卷的Pod一旦使用完毕,存储卷的回收策略将决定是保留存储卷(直到手动删除),还是立即删除数据。持久性数据可预防节点级的故障,并分配比本地更多的可用存储空间。
资源划分
命名空间
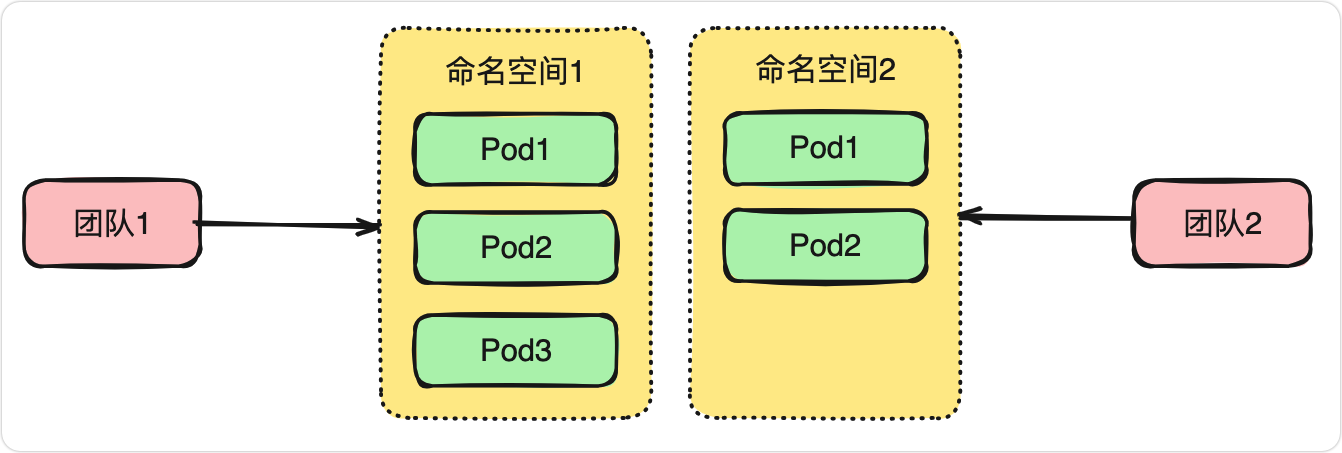
命名空间(namespace)的主要作用是对Kubernetes集群资源进行划分。这种划分并非物理划分而是逻辑划分,用于实现多租户的资源隔离,如图所示:
标签和注解
Kubernetes中的标签(label)是一种语义化标记,可以附加到Kubernetes对象上,对它们进行标记或划分。如果要针对不同的实力进行管理或路由,可以用标签来进行选择。例如,每种基于控制器的对象都可以使用标签来识别需要操作的Pod。Service组件也可以使用标签来确定应该将请求路由到哪些后端Pod,如图所示:
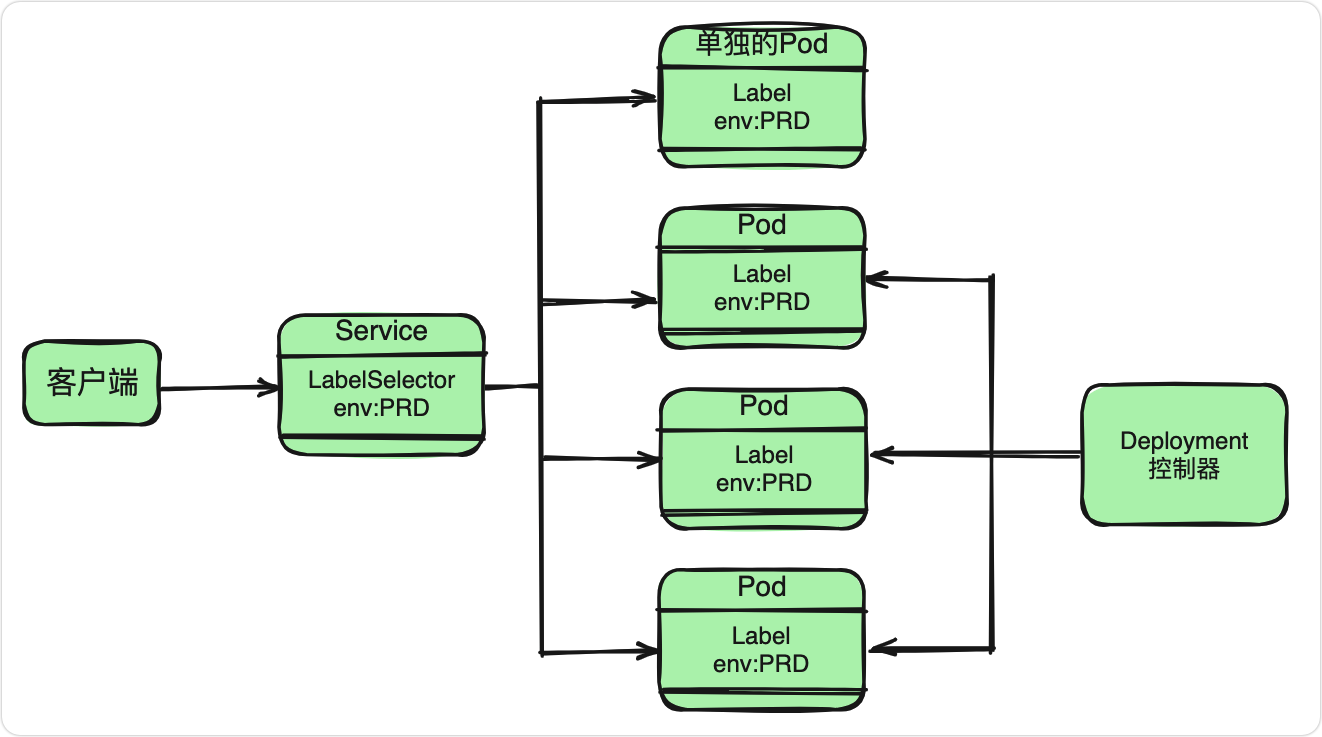
标签的形式是键值对,每个单元可以拥有多个标签,但每个单元对每个键只能拥有一个值。通常来说,相对于当作标识符的name属性,标签的使用更像是对资源进行划分细类,可以用于开发阶段、可访问性级别、应用程序版本等标准对各个对象进行分类。
注解(annotation)也是一种类似的机制,用于将任意键值信息附加到某一对象中。相对于标签,注解更灵活,可以包含少了结构化数据。一般来说,注解只是向对象添加跟多元数据的一种方式,但并不用于筛选。


