Section 196.1: 代码性能分析
首先,您应该能够找到脚本的瓶颈,并注意没有任何优化可以弥补数据结构选择不当或算法设计中的缺陷。其次,不要在编码过程中过早地优化,以免牺牲可读性/设计/质量。唐纳德·克努特(Donald Knuth)曾就优化发表过如下言论:
“我们应该忘掉那些小效率,比如说大约 97% 的时候:过早优化是万恶之源。然而,我们也不应错过那关键的 3% 的机会。”
为了对代码进行性能分析,您有多种工具可供选择:标准库中的 cProfile(或速度较慢的 profile)、line_profiler 和 timeit。它们各自有不同的用途。
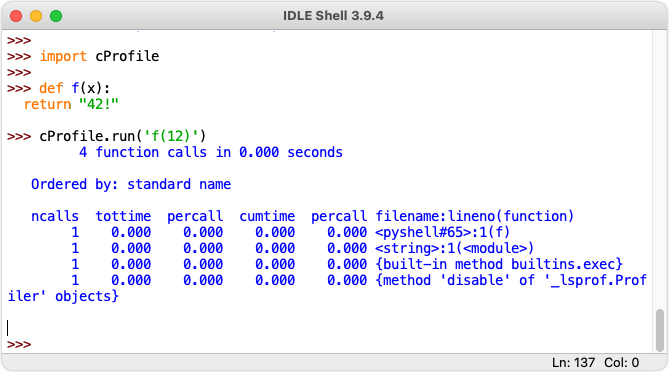
cProfile 是一种确定性性能分析器:它会监控函数调用、函数返回和异常事件,并为这些事件之间的时间间隔(精确到 0.001 秒)进行精确计时。库文档提供了以下简单用例:
import cProfile

def f(x):
  return "42!"
cProfile.run('f(12)')
或者,如果您更愿意包装现有代码的一部分:
import cProfile
import pstats
from io import StringIO

# 创建一个 Profile 对象
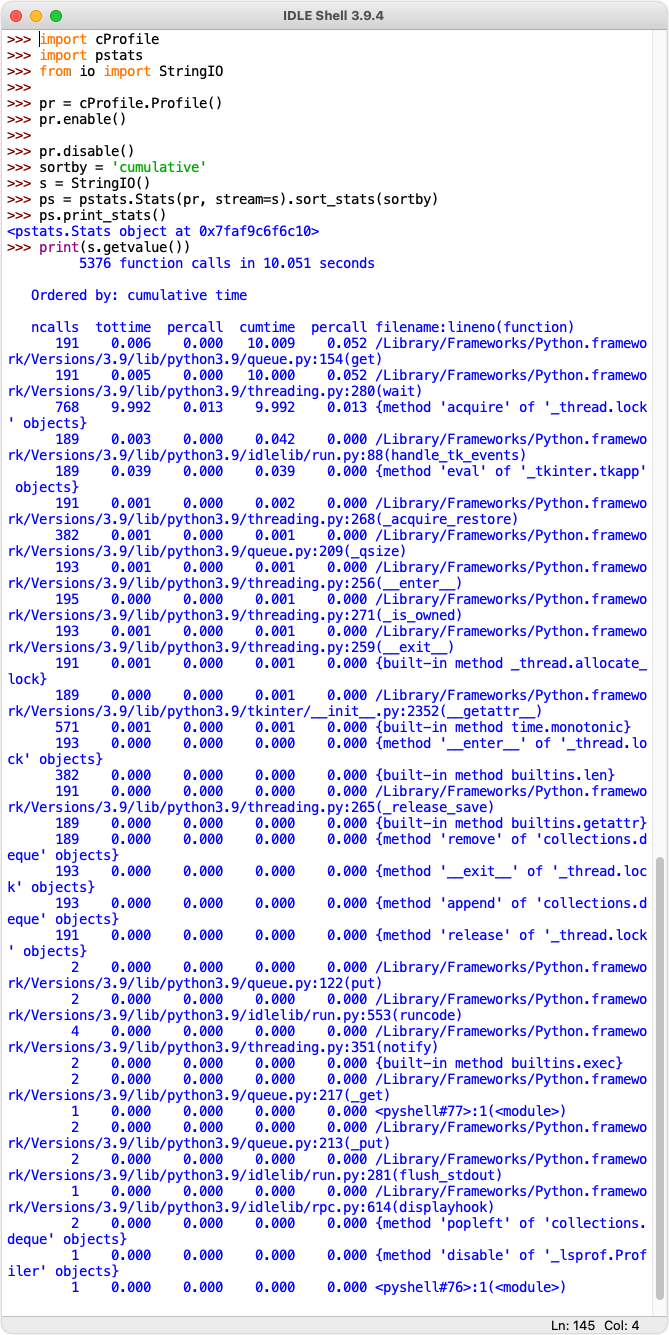
pr = cProfile.Profile()
pr.enable()  # 启用性能分析

# ... 在这里执行需要分析的代码 ...
# ... 长时间运行的代码 ...

pr.disable()  # 禁用性能分析

# 设置排序方式
sortby = 'cumulative'

# 创建一个 StringIO 对象用于存储输出
s = StringIO()

# 创建 pstats.Stats 对象并排序
ps = pstats.Stats(pr, stream=s).sort_stats(sortby)

# 打印性能分析结果到 StringIO 对象
ps.print_stats()

# 获取 StringIO 对象中的内容并打印
print(s.getvalue())
这将生成类似于下表的输出,您可以快速看到程序花费大部分时间的地方,并识别出需要优化的函数。
3 function calls in 0.000 seconds

Ordered by: standard name
ncalls tottime percall cumtime percall filename:lineno(function)
1 0.000 0.000 0.000 0.000 :1(f)
1 0.000 0.000 0.000 0.000 :1()
1 0.000 0.000 0.000 0.000 {method 'disable' of '_lsprof.Profiler' objects}
line_profiler 模块(https://github.com/rkern/line_profiler)可用于逐行分析代码。这显然不适用于长脚本,而是针对代码片段。有关详细信息,请参阅文档。最简单的入门方法是按照包页面上的说明使用 kernprof 脚本,注意您需要手动指定要分析的函数。
$ kernprof -l script_to_profile.py
kernprof 将创建一个 LineProfiler 实例,并将其插入到 __builtins__ 命名空间中,命名为 profile。它被设计为用作装饰器,因此在您的脚本中,您可以用 @profile 装饰您想要分析的函数。
@profile
def slow_function(a, b, c):
  ...
kernprof 的默认行为是将结果放入二进制文件 script_to_profile.py.lprof 中。您可以使用 [-v/--view] 选项告诉 kernprof 立即在终端中查看格式化的结果。否则,您可以稍后像这样查看结果:
$ python -m line_profiler script_to_profile.py.lprof
最后,timeit 提供了一种简单的方法,用于测试单行代码或小表达式,既可以从命令行也可以从 Python shell 中进行。该模块可以回答诸如“将集合转换为列表时,使用列表推导式还是内置的 list() 更快?”之类的问题。查找 setup 关键字或 -s 选项以添加设置代码。
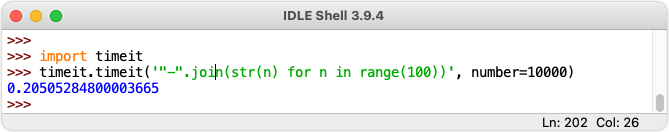
>>> import timeit
>>> timeit.timeit('"-".join(str(n) for n in range(100))', number=10000)
0.8187260627746582
从终端运行:
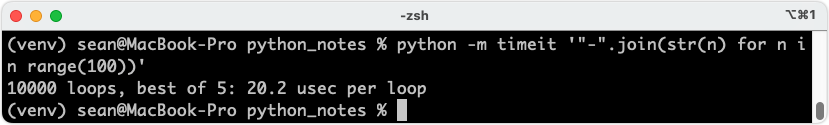
$ python -m timeit '"-".join(str(n) for n in range(100))'
10000 loops, best of 3: 40.3 usec per loop