Python 是一种旨在清晰、可读且无歧义和意外行为的语言。不幸的是,这些目标并非在所有情况下都能实现,这就是为什么 Python 仍然存在一些角落情况,它可能会做一些与您预期不同的事情。
本节将向您展示在编写 Python 代码时可能会遇到的一些问题。
Section 200.1: 列表乘法和共同引用
考虑通过乘法创建嵌套列表结构的情况:
li = [[]] * 3
print(li)
# Out: [[], [], []]
乍一看,我们以为我们有一个包含 3 个不同嵌套列表的列表。让我们尝试向第一个列表中添加 1:
li[0].append(1)
print(li)
# Out: [[1], [1], [1]]
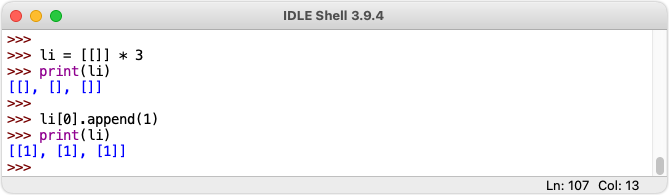
1 被添加到了 li 中的所有列表中。
原因是 [[]] * 3 并没有创建一个包含 3 个不同列表的 list。相反,它创建了一个包含 3 个对同一个 list 对象的引用的 list。因此,当我们向 li[0] 添加内容时,这种变化在 li 的所有子元素中都是可见的。这相当于:
li = []
element = [[]]
li = element + element + element
print(li)
# Out: [[], [], []]
element.append(1)
print(li)
# Out: [[1], [1], [1]]
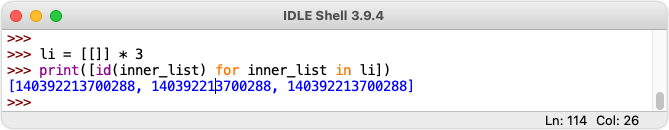
如果使用 id 打印包含列表的内存地址,可以进一步证实这一点:
li = [[]] * 3
print([id(inner_list) for inner_list in li])
# Out: [6830760, 6830760, 6830760]
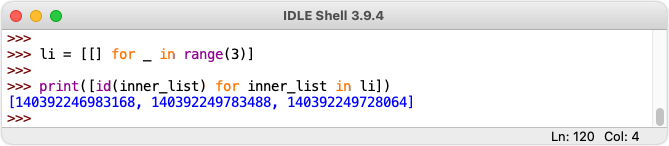
解决方案是使用循环创建内部列表:
li = [[] for _ in range(3)]
与其创建一个单一列表,然后创建 3 个对该列表的引用,我们不如创建 3 个不同的独立列表。同样,可以使用 id 函数来验证这一点:
print([id(inner_list) for inner_list in li])
# Out: [6331048, 6331528, 6331488]
您也可以这样做。这会在每次调用 append 时创建一个新的空列表。
>>> li = []
>>> li.append([])
>>> li.append([])
>>> li.append([])
>>> for k in li: print(id(k))
...
4315469256
4315564552
4315564808
不要使用索引来遍历序列。
不要这样做:
for i in range(len(tab)):
  print(tab[i])
而应该这样做:
for elem in tab:
  print(elem)
for 会自动完成大多数迭代操作。
如果确实需要索引和元素,使用 enumerate。
for i, elem in enumerate(tab):
  print((i, elem))
小心使用 "==" 来检查 True 或 False
if (var == True):
  # 如果 var 是 True 或 1、1.0、1L 等,将执行此操作

if (var != True):
  # 如果 var 既不是 True 也不是 1,将执行此操作

if (var == False):
  # 如果 var 是 False 或 0(或 0.0、0L、0j 等),将执行此操作

if (var == None):
  # 只有当 var 是 None 时才执行

if var:
  # 如果 var 是非空字符串/列表/字典/元组、非 0 等,将执行此操作

if not var:
  # 如果 var 是 ""、{}、[]、()、0、None 等,将执行此操作

if var is True:
  # 只有当 var 是布尔值 True(而不是 1)时才执行

if var is False:
  # 只有当 var 是布尔值 False(而不是 0)时才执行

if var is None:
  # 与 var == None 相同
不要检查是否可以,直接去做并处理错误
Python 程序员通常说“道歉比请求许可更容易”。
不要这样做:
if os.path.isfile(file_path):
  file = open(file_path)
else:
  # do something
而应该这样做:
try:
  file = open(file_path)
except OSError as e:
  # do something
或者使用 Python 2.6+ 的更好方式:
with open(file_path) as file:
这种方式更好,因为它更通用。您可以将 try/except 应用于几乎所有内容。您不需要关心如何防止错误,只需要关心您可能面临的风险。
不要检查类型
Python 是动态类型的,因此检查类型会使您失去灵活性。相反,通过检查行为来使用鸭子类型。如果函数中期望一个字符串,则使用 str() 将任何对象转换为字符串。如果期望一个列表,则使用 list() 将任何可迭代对象转换为列表。
不要这样做:
def foo(name):
  if isinstance(name, str):
    print(name.lower())

def bar(listing):
  if isinstance(listing, list):
    listing.extend((1, 2, 3))
    return ", ".join(listing)
而应该这样做:
def foo(name) :
  print(str(name).lower())

def bar(listing) :
  l = list(listing)
  l.extend((1, 2, 3))
  return ", ".join(l)
使用最后一种方式,foo 将接受任何对象。bar 将接受字符串、元组、集合、列表等更多内容。这是一种廉价的 DRY(Don't Repeat Yourself,不要重复自己)方式。
不要混用空格和制表符
使用 object 作为第一个父类
这是一个棘手的问题,但随着程序的增长,它会困扰您。在 Python 2.x 中,有旧类和新类。旧类是旧的,它们缺少一些功能,并且在继承时可能会有奇怪的行为。为了可用,您的任何类都必须是“新式”的。为此,使其继承自 object。
不要这样做:
class Father:
  pass

class Child(Father):
  pass
而应该这样做:
class Father(object):
  pass

class Child(Father):
  pass
在 Python 3.x 中,所有类都是新式的,因此您不需要这样做。
不要在 __init__ 方法之外初始化类属性
来自其他语言的人会觉得这样做很诱人,因为这就是您在 Java 或 PHP 中所做的。您编写类名,然后列出属性并赋予它们默认值。在 Python 中似乎也可以这样做,然而,这并不是您想象的那样。这样做会设置类属性(静态属性),然后当您尝试获取对象属性时,它会返回其值,除非它是空的。在这种情况下,它将返回类属性。这意味着两个主要危险:
- 如果更改了类属性,那么初始值也会被更改。
- 如果您将可变对象作为默认值,您将在实例之间共享同一个对象。
不要这样做(除非您想要静态):
class Car(object):
  color = "red"
  wheels = [Wheel(), Wheel(), Wheel(), Wheel()]
而应该这样做:
class Car(object):
  def __init__(self):
    self.color = "red"
    self.wheels = [Wheel(), Wheel(), Wheel(), Wheel()]
Section 200.2: 可变默认参数
def foo(li=[]):
  li.append(1)
  print(li)

foo([2])
# Out: [2, 1]

foo([3])
# Out: [3, 1]
这段代码的行为符合预期,但如果我没有传递参数呢?
foo()
# Out: [1] As expected...

foo()
# Out: [1, 1] Not as expected...
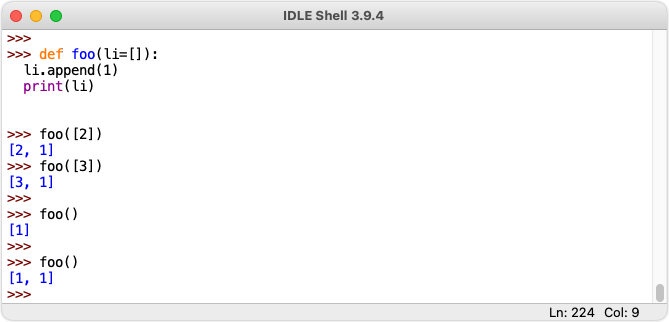
这是因为函数和方法的默认参数是在定义时而不是运行时评估的。因此,我们实际上只有一个 li 列表实例。
解决方法是只使用不可变类型作为默认参数:
def foo(li=None):
  if not li:
    li = []
    li.append(1)
    print(li)

foo()
# Out: [1]

foo()
# Out: [1]
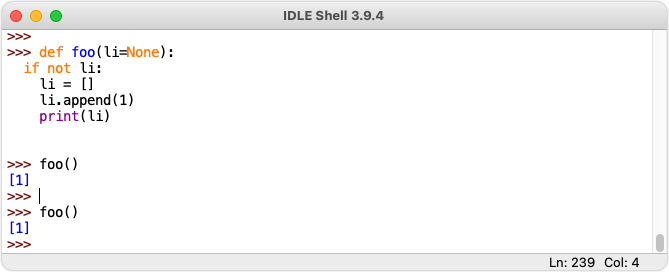
虽然有所改进,但尽管 if not li 正确地评估为 False,许多其他对象也是如此,例如零长度序列。以下示例参数可能会导致意外结果:
x = []
foo(li=x)
# Out: [1]

foo(li="")
# Out: [1]

foo(li=0)
# Out: [1]
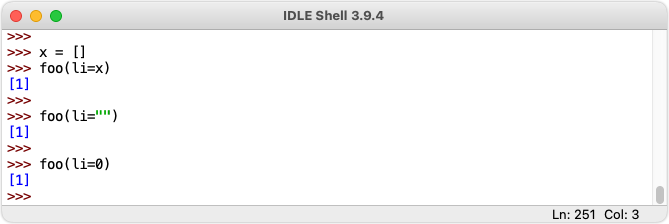
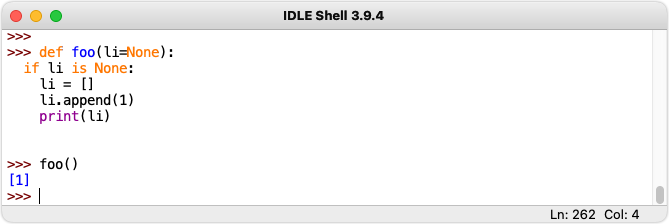
惯用的方法是直接检查参数是否为 None 对象:
def foo(li=None):
  if li is None:
    li = []
    li.append(1)
    print(li)

foo()
# Out: [1]
Section 200.3: 修改正在迭代的序列
for 循环会迭代一个序列,因此在循环内部修改这个序列可能会导致意外的结果(尤其是在添加或删除元素时):
alist = [0, 1, 2]
for index, value in enumerate(alist):
  alist.pop(index)
print(alist)
# Out: [1]
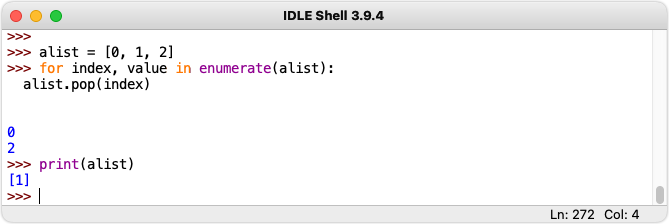
注意:这里使用 list.pop() 来从列表中删除元素。
第二个元素没有被删除,因为迭代是按索引顺序进行的。上述循环迭代了两次,结果如下:
# Iteration #1
index = 0
alist = [0, 1, 2]
alist.pop(0) # removes '0'

# Iteration #2
index = 1
alist = [1, 2]
alist.pop(1) # removes '2'

# loop terminates, but alist is not empty:
alist = [1]
这个问题出现是因为在按索引递增的方向迭代时,索引发生了变化。为了避免这个问题,您可以反向迭代循环:
alist = [1,2,3,4,5,6,7]
for index, item in reversed(list(enumerate(alist))):
  # delete all even items
  if item % 2 == 0:
    alist.pop(index)

print(alist)
# Out: [1, 3, 5, 7]
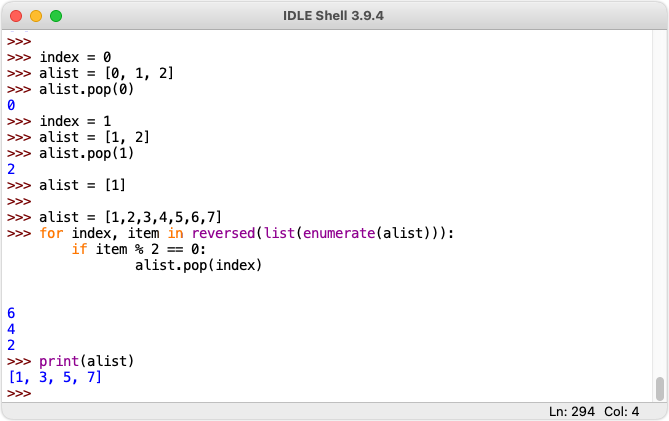
从循环的末尾开始迭代,当添加或删除项目时,它不会影响列表中早期项目的索引。因此,这个例子将正确地从 alist 中删除所有偶数项。
当向正在迭代的列表中插入或追加元素时,也会出现类似的问题,这可能会导致无限循环:
alist = [0, 1, 2]

for index, value in enumerate(alist):
  # break to avoid infinite loop:
  if index == 20:
    break
  alist.insert(index, 'a')
print(alist)
# Out (abbreviated): ['a', 'a', ..., 'a', 'a', 0, 1, 2]
如果没有 break 条件,循环将一直插入 'a',直到计算机内存不足且程序被允许继续运行。在这种情况下,通常更倾向于创建一个新列表,并在迭代原始列表时将项目添加到新列表中。
在使用 for 循环时,您不能使用占位符变量修改列表元素:
alist = [1,2,3,4]

for item in alist:

if item % 2 == 0:

item = 'even'

print(alist)
# Out: [1,2,3,4]
在上述示例中,修改 item 实际上并没有改变原始列表中的任何内容。您需要使用列表索引(alist[2]),enumerate() 在这里非常适用:
alist = [1,2,3,4]
for index, item in enumerate(alist):
  if item % 2 == 0:
    alist[index] = 'even'
print(alist)
# Out: [1, 'even', 3, 'even']
在某些情况下,while 循环可能是更好的选择:
如果要删除列表中的所有元素:
zlist = [0, 1, 2]
while zlist:
  print(zlist[0])
  zlist.pop(0)
print('After: zlist =', zlist)

# Out: 0
# 1
# 2
# After: zlist = []
虽然简单地重置 zlist 也可以达到相同的效果;
zlist = []
上述示例也可以与 len() 结合使用,以在某个点停止,或者在列表中保留 x 个元素:
zlist = [0, 1, 2]
x = 1
while len(zlist) > x:
  print(zlist[0])
  zlist.pop(0)
print('After: zlist =', zlist)

# Out: 0
# 1
# After: zlist = [2]
或者在迭代列表时删除满足特定条件的元素(在这个例子中是删除所有偶数元素):
zlist = [1,2,3,4,5]
i = 0

while i < len(zlist):
  if zlist[i] % 2 == 0:
    zlist.pop(i)
  else:
    i += 1
print(zlist)
# Out: [1, 3, 5]
注意,在删除元素后不要增加 i。通过删除 zlist[i] 处的元素,下一个元素的索引会减少 1,因此在下一次迭代中使用相同的 i 值检查 zlist[i],您将正确地检查列表中的下一个元素。
另一种思考方式是将不需要的元素从列表中移除,即将需要的元素添加到一个新列表中。以下示例是上一个 while 循环示例的替代方案:
zlist = [1,2,3,4,5]

z_temp = []
for item in zlist:
  if item % 2 != 0:
    z_temp.append(item)
zlist = z_temp
print(zlist)
# Out: [1, 3, 5]
在这里,我们将期望的结果收集到一个新列表中。然后,我们可以选择将临时列表重新分配给原始变量。
按照这种趋势,您可以调用 Python 最优雅和强大的特性之一:列表推导式,它消除了临时列表,并偏离了前面讨论的原地列表/索引变异思想。
zlist = [1,2,3,4,5]
[item for item in zlist if item % 2 != 0]
# Out: [1, 3, 5]
Section 200.4: 整数和字符串的身份
Python 使用内部缓存来存储一系列整数,以减少因重复创建这些整数而产生的不必要开销。
实际上,这可能会导致比较整数身份时出现令人困惑的行为:
>>> -8 is (-7 - 1)
False
>>> -3 is (-2 - 1)
True
再举一个例子:
>>> (255 + 1) is (255 + 1)
True
>>> (256 + 1) is (256 + 1)
False
等等,什么?
我们可以看到,对于某些整数(-3, 256),身份运算符 is 返回 True,但对于其他整数(-8, 257)则返回 False。
更具体地说,范围在 [-5, 256] 内的整数在解释器启动时会进行内部缓存,并且只创建一次。因此,它们是相同的,使用 is 比较它们的身份时会返回 True;范围外的整数通常是即时创建的,它们的身份比较返回 False。
这是一个常见陷阱,因为测试时经常使用这个范围内的数字,但足够多的时候,代码会在后期阶段(或者更糟糕的是——生产环境中)失败,没有任何明显的原因,尽管在开发过程中运行完美。
解决方法是始终使用等值运算符(==)而不是身份运算符(is)来比较值。
Python 还会保留对常用字符串的引用,当比较字符串的身份(即使用 is)时,也会导致类似的令人困惑的行为。
>>> 'python' is 'py' + 'thon'
True
字符串 'python' 是常用的,因此 Python 为所有引用字符串 'python' 的对象使用同一个对象。
对于不常用的字符串,即使字符串相等,比较身份也会失败。
>>> 'this is not a common string' is 'this is not' + ' a common string'
False

>>> 'this is not a common string' == 'this is not' + ' a common string'
True
因此,就像整数的规则一样,始终使用等值运算符(==)而不是身份运算符(is)来比较字符串值。
Section 200.5: 字典是无序的
您可能会期望 Python 字典按键排序,就像 C++ 中的 std::map 一样,但事实并非如此:
myDict = {'first': 1, 'second': 2, 'third': 3}
print(myDict)
# Out: {'first': 1, 'second': 2, 'third': 3}

print([k for k in myDict])
# Out: ['second', 'third', 'first']
Python 没有任何内置类可以自动按键排序其元素。
然而,如果排序不是必须的,而您只是希望字典记住其键/值对的插入顺序,您可以使用 collections.OrderedDict:
from collections import OrderedDict

oDict = OrderedDict([('first', 1), ('second', 2), ('third', 3)])

print([k for k in oDict])
# Out: ['first', 'second', 'third']
请注意,使用标准字典初始化 OrderedDict 不会以任何方式为您排序字典。这种结构所做的一切就是保留键插入的顺序。
Python 3.6 中字典的实现发生了变化,以改善其内存消耗。这种新实现的一个副作用是,它还保留了传递给函数的关键字参数的顺序:
Python 3.x Version ≥ 3.6
def func(**kw): print(kw.keys())

func(a=1, b=2, c=3, d=4, e=5)
dict_keys(['a', 'b', 'c', 'd', 'e']) # expected order
注意:请注意,“这种新实现的顺序保持特性被认为是实现细节,不应依赖它”,因为它可能会在未来发生变化。
Section 200.6: 列表推导式和 for 循环中的变量泄露
考虑以下列表推导式:
Python 2.x Version ≤ 2.7
i = 0
a = [i for i in range(3)]
print(i) # Outputs 2
这仅在 Python 2 中发生,因为列表推导式“泄露”了循环控制变量到周围的作用域中(来源)。这种行为可能会导致难以发现的错误,并且已经在 Python 3 中修复。
Python 3.x Version ≥ 3.0
i = 0
a = [i for i in range(3)]
print(i) # Outputs 0
类似地,for 循环对其迭代变量没有私有作用域
i = 0
for i in range(3):
  pass
print(i) # Outputs 2
这种行为在 Python 2 和 Python 3 中都会发生。
为了避免变量泄露问题,在列表推导式和 for 循环中适当使用新变量。
Section 200.7: or 运算符的链式使用
当测试多个等式比较中的任何一个时:
if a == 3 or b == 3 or c == 3:
可能会诱使您将其简化为
if a or b or c == 3: # Wrong
这是错误的;or 运算符的优先级低于 ==,因此表达式将被评估为 if (a) or (b) or (c == 3):。正确的方法是显式检查所有条件:
if a == 3 or b == 3 or c == 3: # Right Way
或者,可以使用内置的 any() 函数来代替链式 or 运算符:
if any([a == 3, b == 3, c == 3]): # Right
或者,为了提高效率:
if any(x == 3 for x in (a, b, c)): # Right
或者,为了更简洁:
if 3 in (a, b, c): # Right
在这里,我们使用 in 运算符来测试值是否存在于包含我们要比较的值的元组中。
类似地,以下写法是错误的:
if a == 1 or 2 or 3:
应该写为:
if a in (1, 2, 3):
Section 200.8: sys.argv[0] 是正在执行的文件名
sys.argv[0] 的第一个元素是正在执行的 Python 文件名。其余元素是脚本参数。
# script.py
import sys

print(sys.argv[0])
print(sys.argv)
$ python script.py
=> script.py
=> ['script.py']

$ python script.py fizz
=> script.py
=> ['script.py', 'fizz']

$ python script.py fizz buzz
=> script.py
=> ['script.py', 'fizz', 'buzz']
Section 200.9: 访问整数字面量的属性
您可能听说过 Python 中的一切都是对象,包括字面量。这意味着,例如,7 也是一个对象,这意味着它有属性。其中一个属性是 bit_length。它返回表示其被调用值所需的位数。
x = 7
x.bit_length()
# Out: 3
看到上面的代码可以工作,您可能会直觉地认为 7.bit_length() 也可以工作,结果却发现它引发了 SyntaxError。为什么?因为解释器需要区分属性访问和浮点数(例如 7.2 或 7.bit_length())。它做不到,所以会引发异常。
有几种方法可以访问整数字面量的属性:
# parenthesis
(7).bit_length()

# a space
7 .bit_length()
使用两个点(像这样 7..bit_length())在这种情况下是不行的,因为这会创建一个浮点数字面量,而浮点数没有 bit_length() 方法。
当访问浮点数字面量的属性时不存在这个问题,因为解释器足够“聪明”,知道浮点数字面量不能包含两个 .,例如:
7.2.as_integer_ratio()
# Out: (8106479329266893, 1125899906842624)
Section 200.10: 全局解释器锁(GIL)和阻塞线程
关于 Python 的 GIL,已经有很多讨论。在处理多线程(不要与多进程混淆)应用程序时,它有时会引起混淆。
以下是一个示例:
import math
from threading import Thread

def calc_fact(num):
  math.factorial(num)

num = 600000
t = Thread(target=calc_fact, daemon=True, args=[num])
print("即将计算:{}!".format(num))
t.start()
print("正在计算...")
t.join()
print("计算完成")
您会期望在启动线程后立即看到打印出的“正在计算...”,毕竟我们希望计算在一个新线程中进行!但实际上,您会看到它在计算完成后才被打印出来。这是因为新线程依赖于一个 C 函数(math.factorial),该函数在执行时会锁定 GIL。
有几种解决方法。第一种是在 Python 中实现您的阶乘函数。这将允许主线程在您处于循环中时获取控制权。缺点是这个解决方案会慢得多,因为我们不再使用 C 函数了。
def calc_fact(num):
  """ A slow version of factorial in native Python """
  res = 1
  while num >= 1:
    res = res * num
    num -= 1
  return res
您也可以在开始执行前让程序休眠一段时间。注意:这实际上并不会中断 C 函数中正在进行的计算,但它会允许主线程在启动后继续执行,这可能正是您所期望的。
def calc_fact(num):
  sleep(0.001)
  math.factorial(num)
Section 200.11: 多重返回
函数 xyz 返回两个值 a 和 b:
def xyz():
  return a, b
调用 xyz 的代码将结果存储在一个变量中,假设 xyz 只返回一个值:
t = xyz()
实际上,t 的值是一个元组 (a, b),因此对 t 执行任何假设它不是元组的操作都可能在代码深处以一个关于元组的意外错误失败。
TypeError: 类型元组没有定义 ... 方法
修复方法是:
a, b = xyz()
初学者仅通过阅读元组错误消息很难找到这条消息的原因!
Section 200.12: Pythonic JSON 键
my_var = 'bla';
api_key = 'key';
...lots of code here...
params = {"language": "en", my_var: api_key}
如果您习惯于 JavaScript,Python 字典中的变量求值不会像您预期的那样。在 JavaScript 中,这条语句将得到如下所示的 params 对象:
{
  "language": "en",
  "my_var": "key"
}
然而,在 Python 中,它将得到如下所示的字典:
{
  "language": "en",
  "bla": "key"
}
my_var 被求值,其值被用作键。


