摘要
它给数据加存储,用的是浏览器最常见的方案,能用——但运维本能告诉我那是黑盒:看不见、带不走。我退回去重做,只要真 SQLite。这篇讲怎么向 AI 描述"我要什么样的数据",报修三段式模板,以及用 sqlite3 打开自己导出数据库的那一刻。
话题标签:#WorkBuddy #SQLite #AI改代码 #零代码
它给的建议没错,但我退回去了
上一篇结尾说了,第一版数据在内存里,F5 一按全没。第一轮迭代,头号任务就是把存储加上。
我给它的指令特别简短:
把数据保存加上,刷新不能丢。
它很快改完了,附了说明:"数据已保存在浏览器的 localStorage 中,刷新、关闭浏览器都不会丢失。"
我测了。真的不丢了。功能层面,这次交付没毛病。
但我心里堵得慌。堵在哪?我说不清楚,直到我干了运维都会干的那件事:打开引擎盖看看。
浏览器按 F12,翻到应用存储那一栏。我看到了我的数据:一串字符串,挤在一个叫 localStorage 的格子里。
能存,但我看不见结构。哪条是内容、哪条是优先级?没有表、没有字段,就是一坨序列化后的文本。我想导出?理论上可以写脚本把这段文本抠出来——但那已经不是"导出数据"了,那是考古。
干了八年运维,我对数据的底线一直就三条:看得见结构,导得出文件,接得上标准工具。localStorage 一条都不满足。它不是坏方案——它对大多数人是最好的方案——但它不适合我。
第二轮沟通:把"不满意"翻译成"需求"
我把第一版存储退回去了。这次我没有再说"你改一下",我把话想清楚了才发:
存储方案重做。要求如下:
- 用 SQLite——是真的 SQLite,不是叫起来像的东西。我要能导出一个
.sqlite文件- 导出的文件我要能用
sqlite3命令行打开,有正经的表结构(字段、类型都要有)- 界面上加一个"导出"按钮,点一下就下载这个 .sqlite 文件
- 顺便把优先级(高/中/低)加上,高的排前面;已完成的沉底
- 已有条目支持双击改文字
它回了一段让我印象很深的话,大意是:浏览器里可以跑真正的 SQLite。官方的 SQLite 引擎被编译成了 WebAssembly(一种能在浏览器里运行的二进制格式,你可以理解为"把 SQLite 这台机器整个搬进了浏览器"),数据库文件本体放在浏览器本地存储里,界面上随时可以导出成标准 .sqlite。
它还补了一句:"这个方案的代价是页面体积会大几百 KB(引擎本身),功能上和你在命令行用的 SQLite 是同一个东西。"
几百 KB,换一个我能用 sqlite3 打开的真数据库?这买卖闭着眼睛做。
这就是向 AI 提需求的正确姿势的完整样本,我把它总结成三段式,后面所有迭代我都在用:
【现象/现状】现在数据存在 localStorage 里,是序列化后的黑盒文本 【问题】我看不见结构、导不出文件、接不上标准工具 【期望】换成浏览器内 SQLite,可导出 .sqlite,sqlite3 能直接打开;附带把优先级和双击编辑做了
第一句"把数据保存加上"为什么效果差?因为我只说了要什么,没说验收标准。它给了个业界常规答案,错的是我没把底线写出来。
导出那一下,是我这个系列最爽的一秒
改完之后,我做了那件等了两个篇章的事。
页面底部多了一排按钮:导出 .sqlite。点一下,浏览器下载了一个文件:todo-2026-09-20.sqlite。
我打开终端,敲下这几周最舒展的一串命令:
$ sqlite3 todo-2026-09-20.sqlite
sqlite> .schema
CREATE TABLE todos (
  id INTEGER PRIMARY KEY,
  text TEXT NOT NULL,
  priority TEXT DEFAULT '中',
  due TEXT,
  category TEXT DEFAULT '工作',
  done INTEGER DEFAULT 0,
  created_at TEXT,
  updated_at TEXT
);
sqlite> SELECT text, priority FROM todos WHERE done=0 ORDER BY priority;
表结构、字段、类型,全在。我甚至直接写了个 WHERE 查询,把没完成的按优先级拉出来——就像查公司任何一个生产库一样。
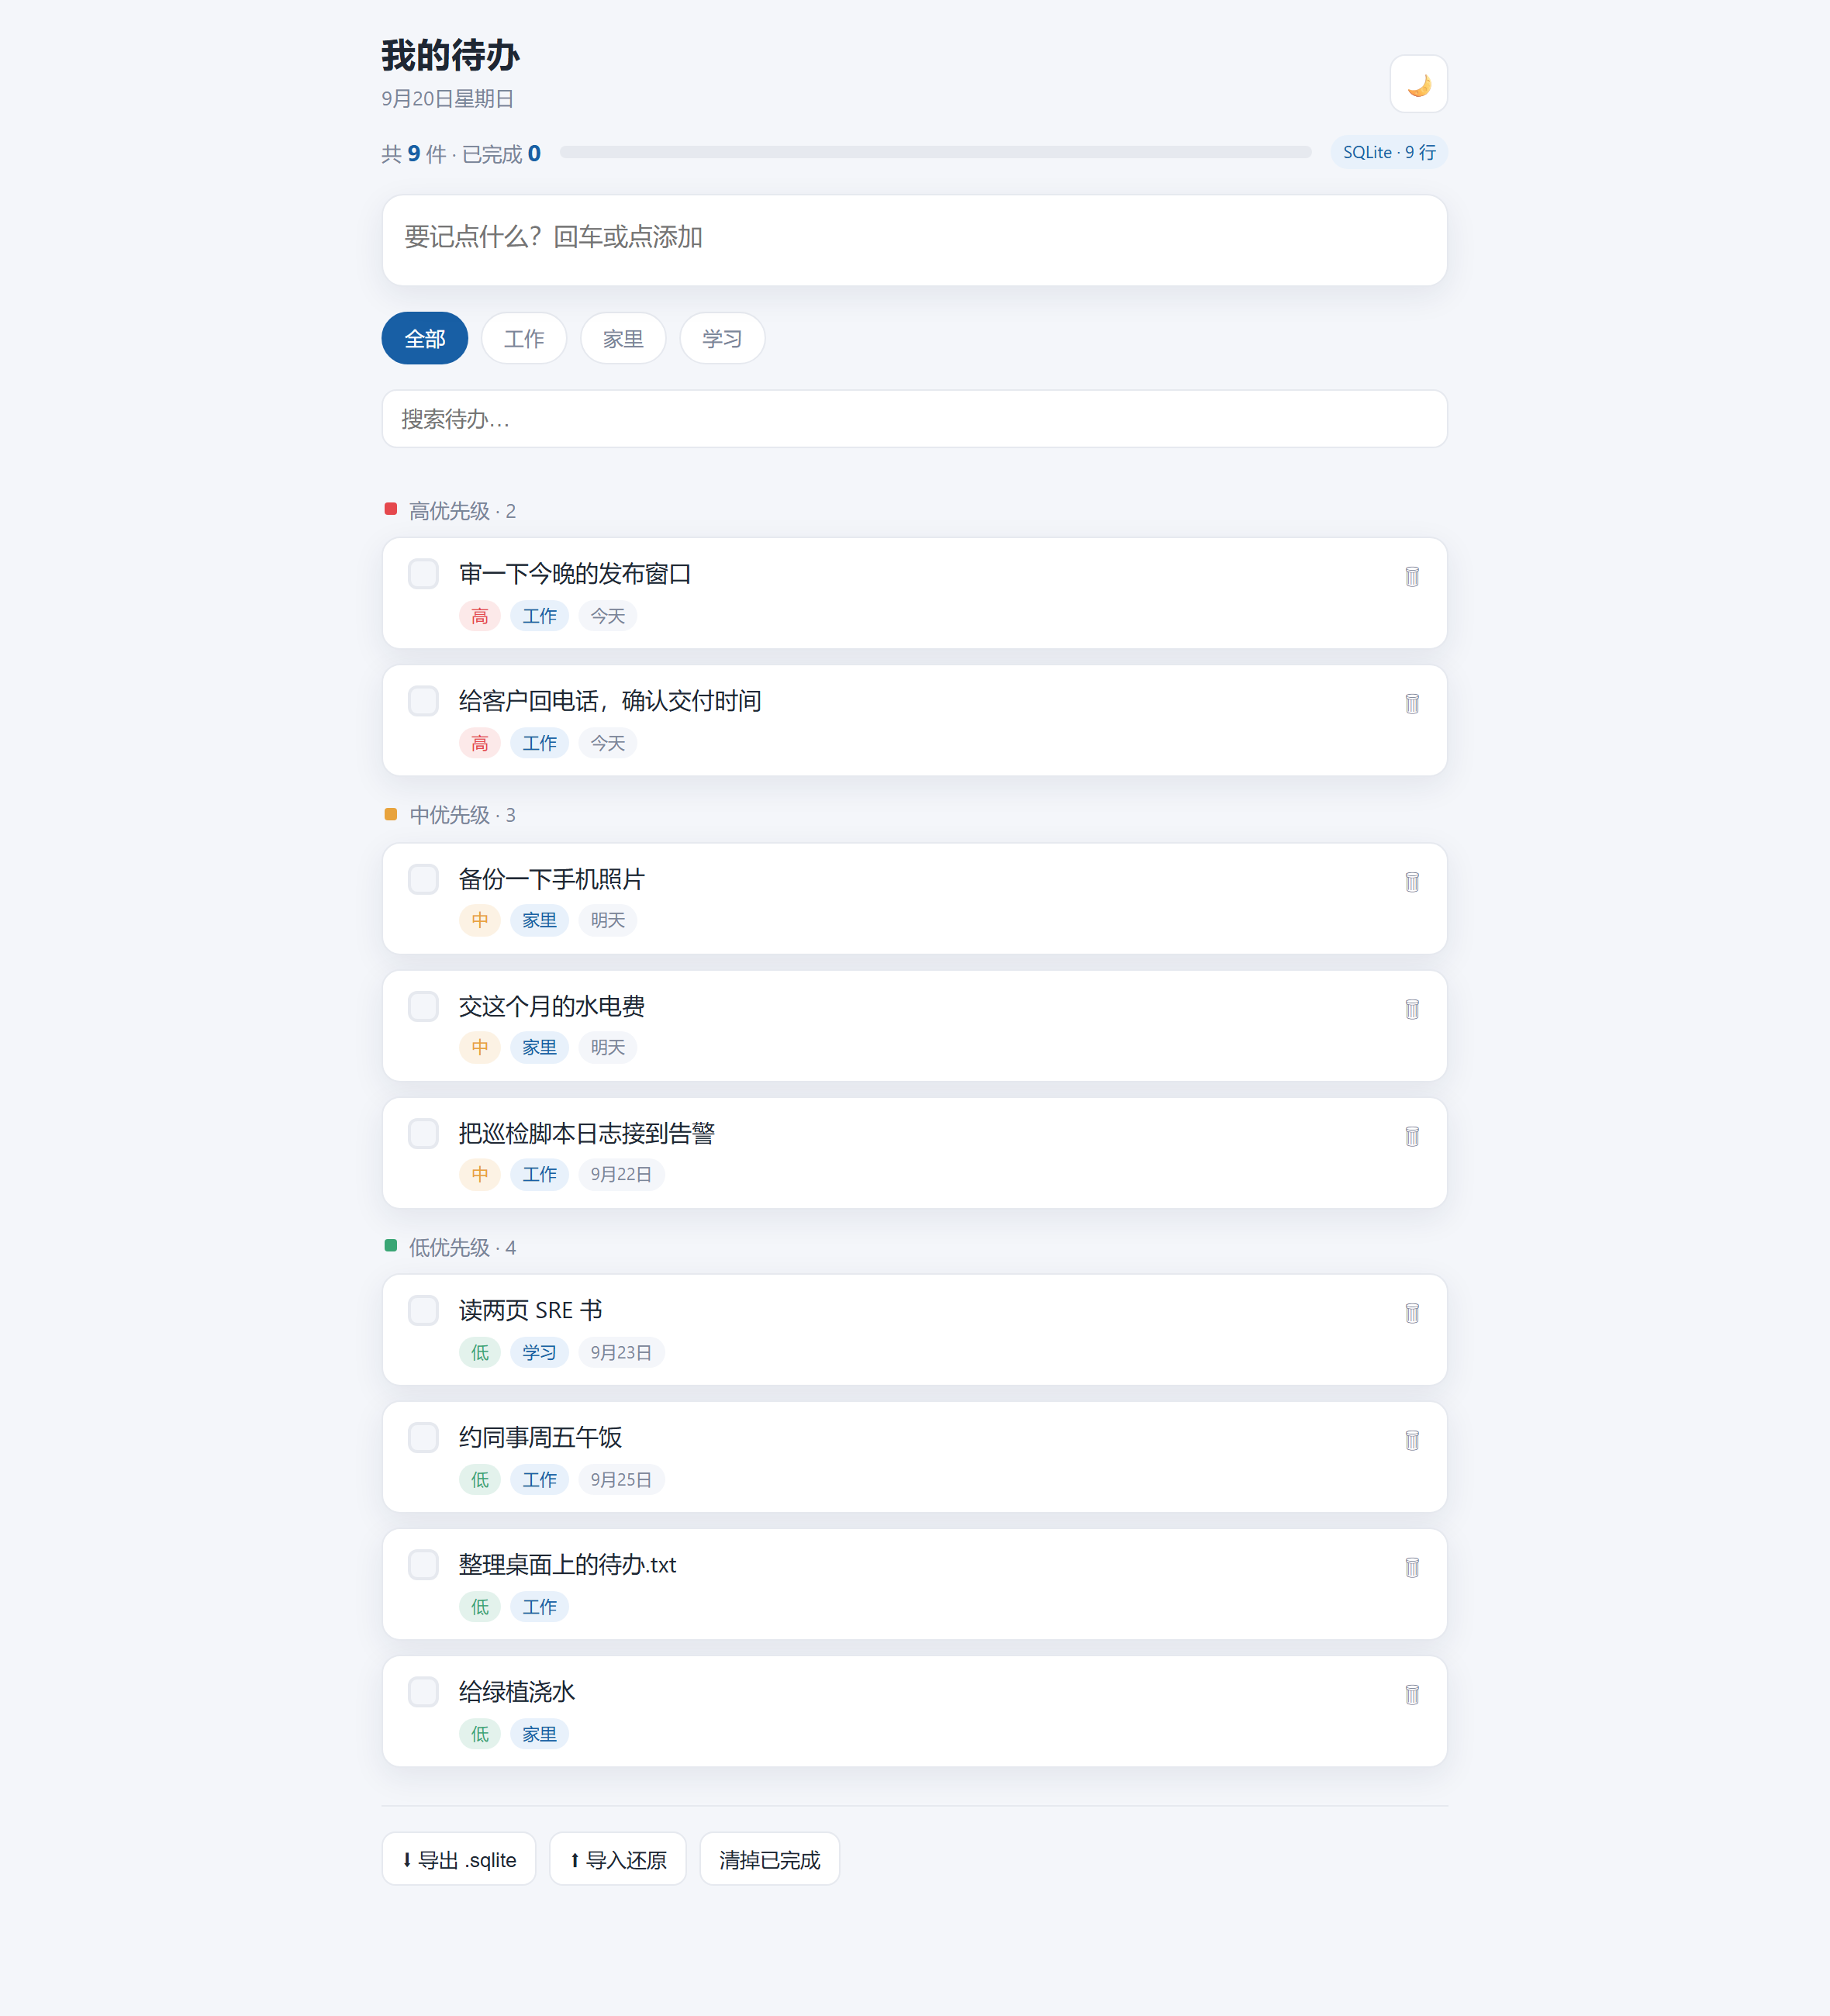
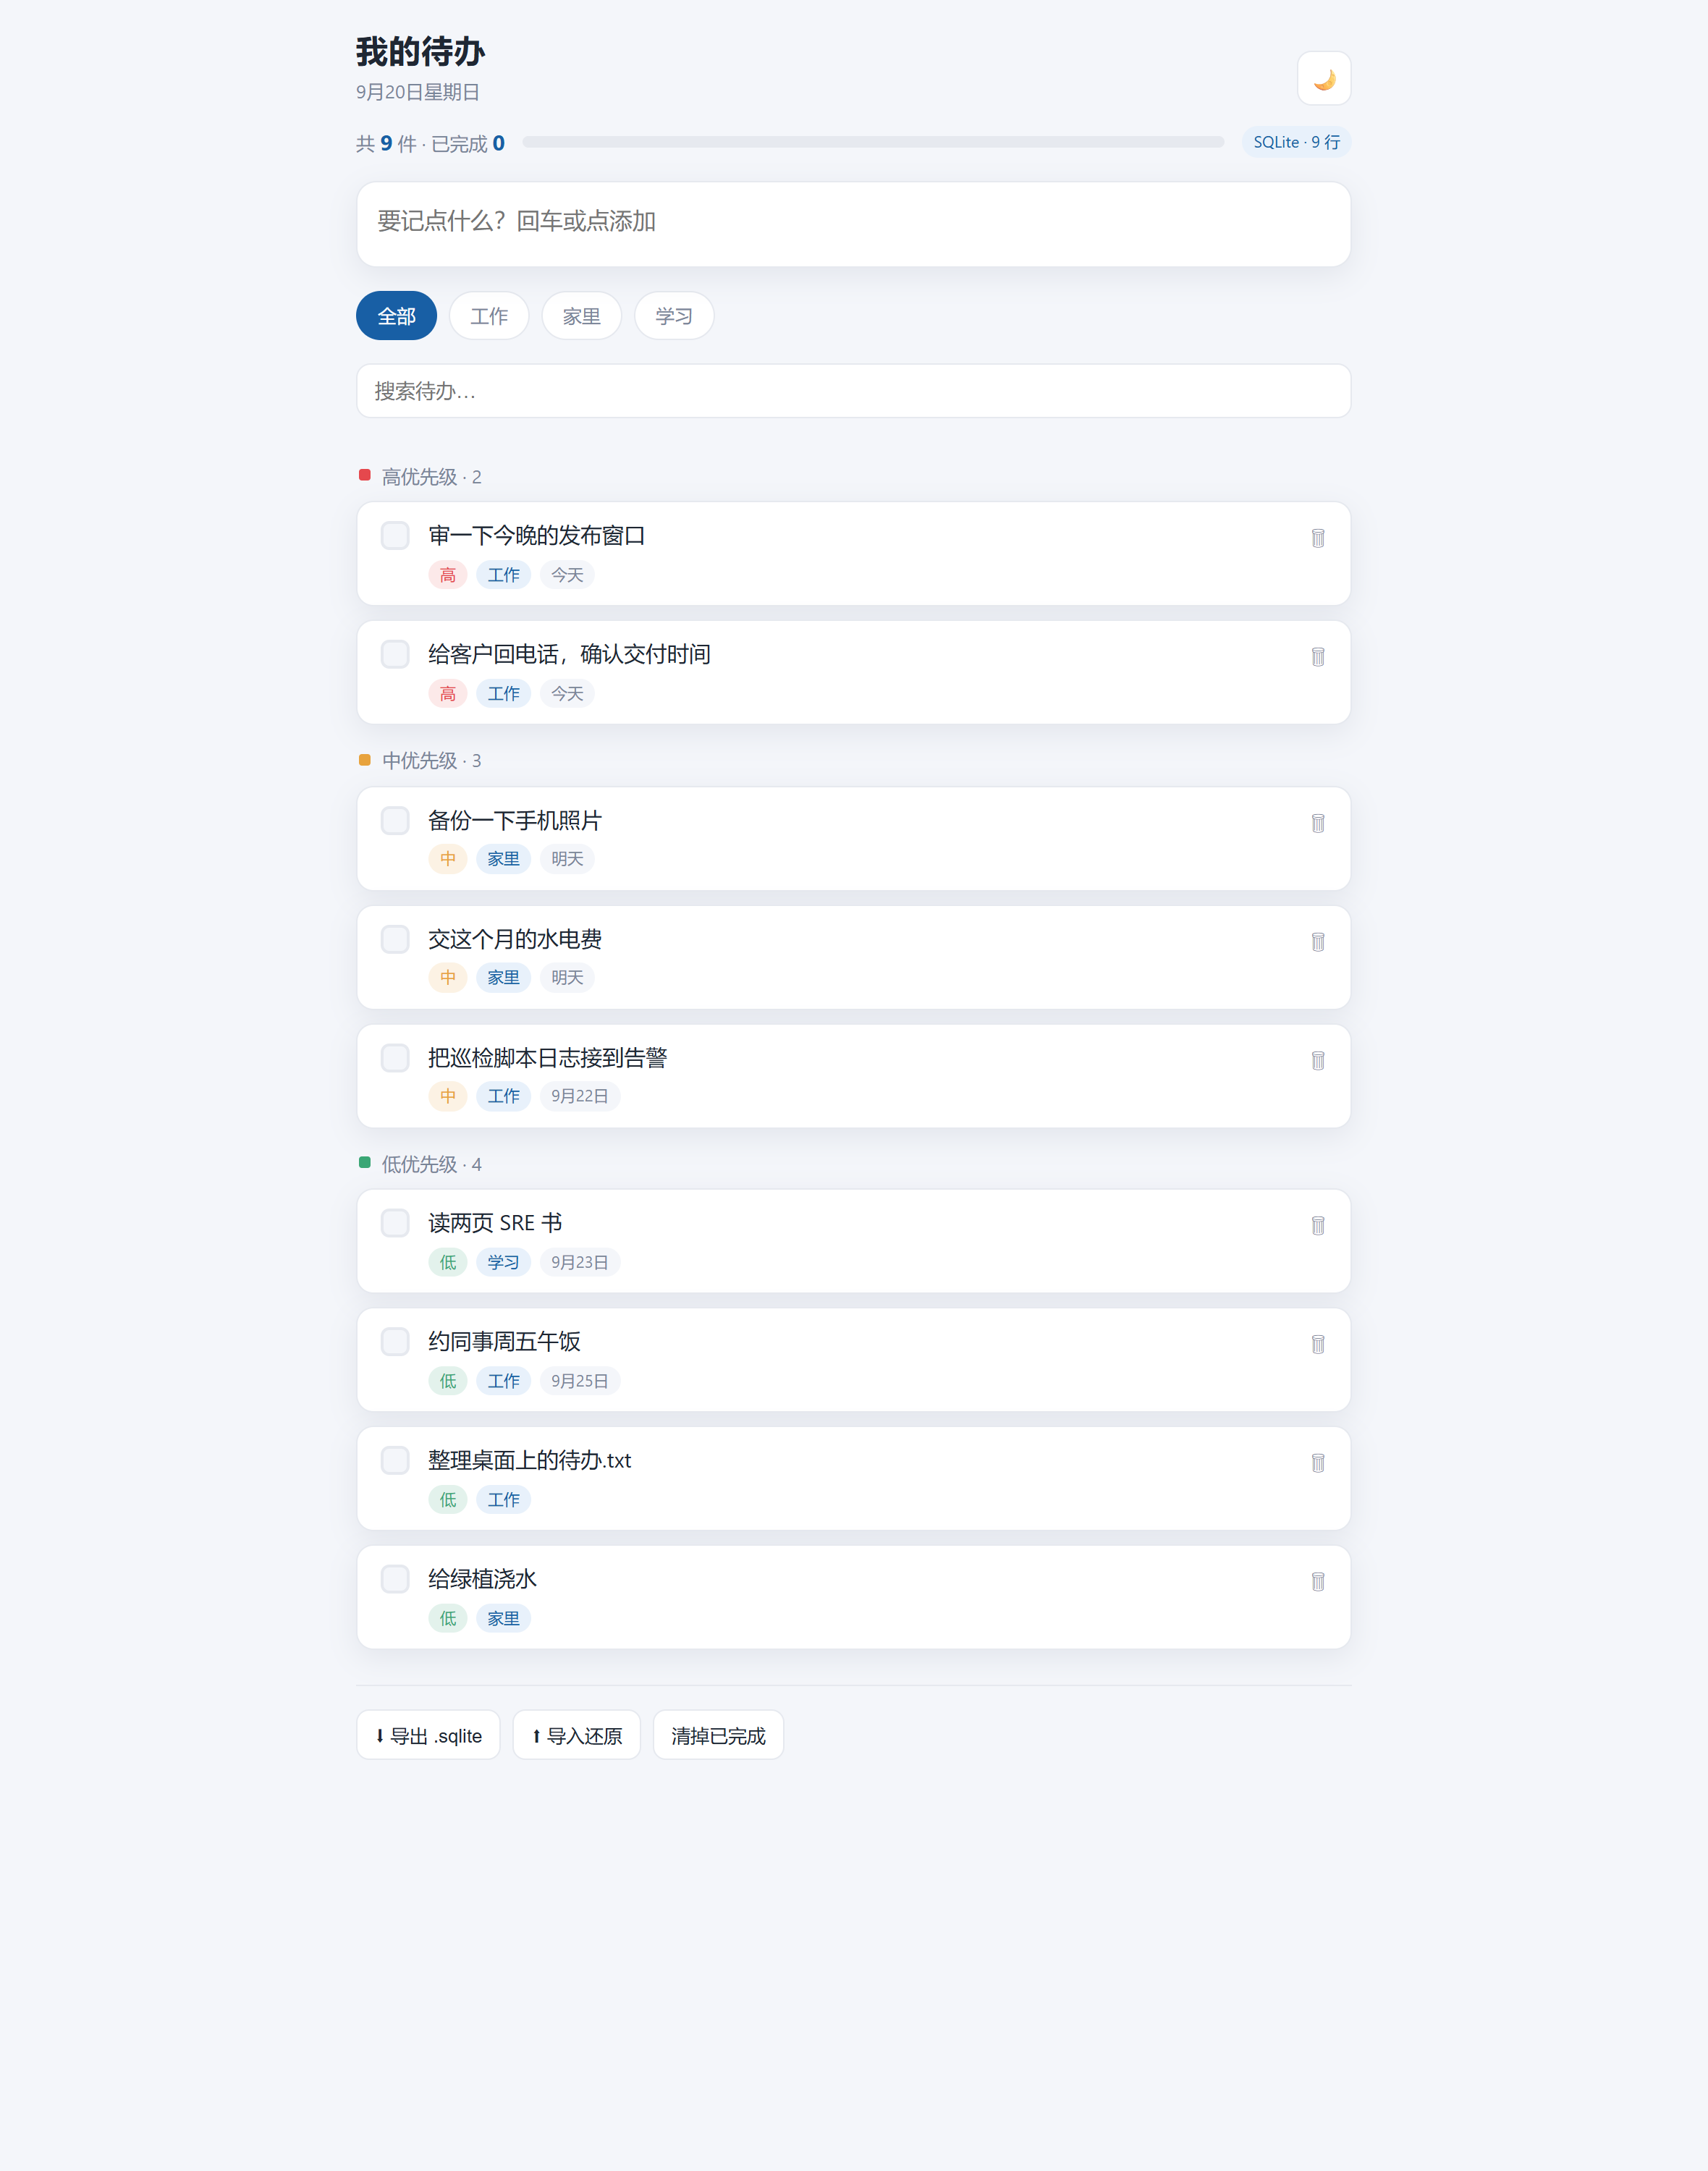
各位同行应该懂这一刻的意义:这个浏览器里的页面,对我来说不再是"某个网站",是一个数据在我手里、随时可以被审计的存储节点。数据是 SQLite 的,界面只是个壳——这个架构我熟,跟公司那些"SQLite + Web 界面"的内部小系统一模一样,只不过这次跑在我自己电脑的浏览器里。
顺便说:优先级分组和双击改字,一次就对了
这轮迭代还带了两个功能,都一次做对了:
- 优先级:每条待办标高/中/低,高优在上、已完成的沉底。录入的时候三个胶囊按钮点一下就行
- 双击改字:列表里双击任何一条,直接改成文字,回车保存
为什么这次一次就对?对比第一句"把数据保存加上",这次的指令多了验收标准(可导出、sqlite3 可打开、高优在上、已完成的沉底)。AI 不是猜不中,是你没给它猜的靶子。
这轮烧掉的积分,值不值
这轮实际是两轮沟通:第一轮 localStorage(用着别扭,退回),第二轮 SQLite(到位)。有读者会想:第一轮是不是白烧了?
我算过这笔账,不是白烧。理由有三:
- 它用实际交付证明了 localStorage 是常规解,让我确认"常规解不满足我"不是我臆想,是真实的方案差异
- 退回时的三段式沟通模板,是被这次失败逼出来的,后面 5 篇全在用
- 总消耗完全在预算内(账本见文末)
但我同样把这个教训刻在这:如果你的数据底线是"看得见、带得走",第一天就写进需求卡,别等交付了再退。验收标准晚说一轮,就是一轮积分。
下一篇预告
存储踏实了,数据是我的了。下一步是功能:截止日期、分类、还有那个让我纠结了很久的筛选。
这一轮我会学到跟 AI 描述界面的正确语言——不是"好看点""合理点",而是像画部署图一样,说清楚"哪个位置放什么、按什么规则排"。


