摘要
加搜索功能,它改完,整个列表点不动了,页面飘着报错。这篇讲我的第一次救火:先看影响范围、再回退、然后带证据报修——报错原文一字不改贴给它,让它先说原因再动手。运维的排障流程,在 AI 编程上一个字都不用改。
话题标签:#WorkBuddy #AI改代码 #排障 #零代码
前面八篇都太顺了,这篇还债
写到这我必须坦白:前面八篇虽然翻过车(彩虹渐变)、烧过错钱(模糊指令),但从没真正"崩"过——崩的意思是:功能不可用,页面报错,你不知道它干了什么。
这篇就是那次崩。
起因特别平常:搜索。30 多行待办,分类筛选有了,但我经常记不清一条待办在哪个分类,只记得一个词。加个搜索框,按关键词过滤——需求清晰,一轮搞定的事。
我给的指令(注意,这次我用的也是"位置语言"):
输入框下方加一个搜索框,占满一行。输入关键词时,列表实时过滤,只显示文字里包含关键词的条目。清空搜索框就恢复全部。
指令本身没毛病。它改完我打开页面——坏了。
现场长这样
列表区整块空白。输入框、分类标签都还在,但下面一条待办都没有。页面顶上还多了一条红色的报错条,写着一串英文:
ReferenceError: brokenSearchVar is not defined
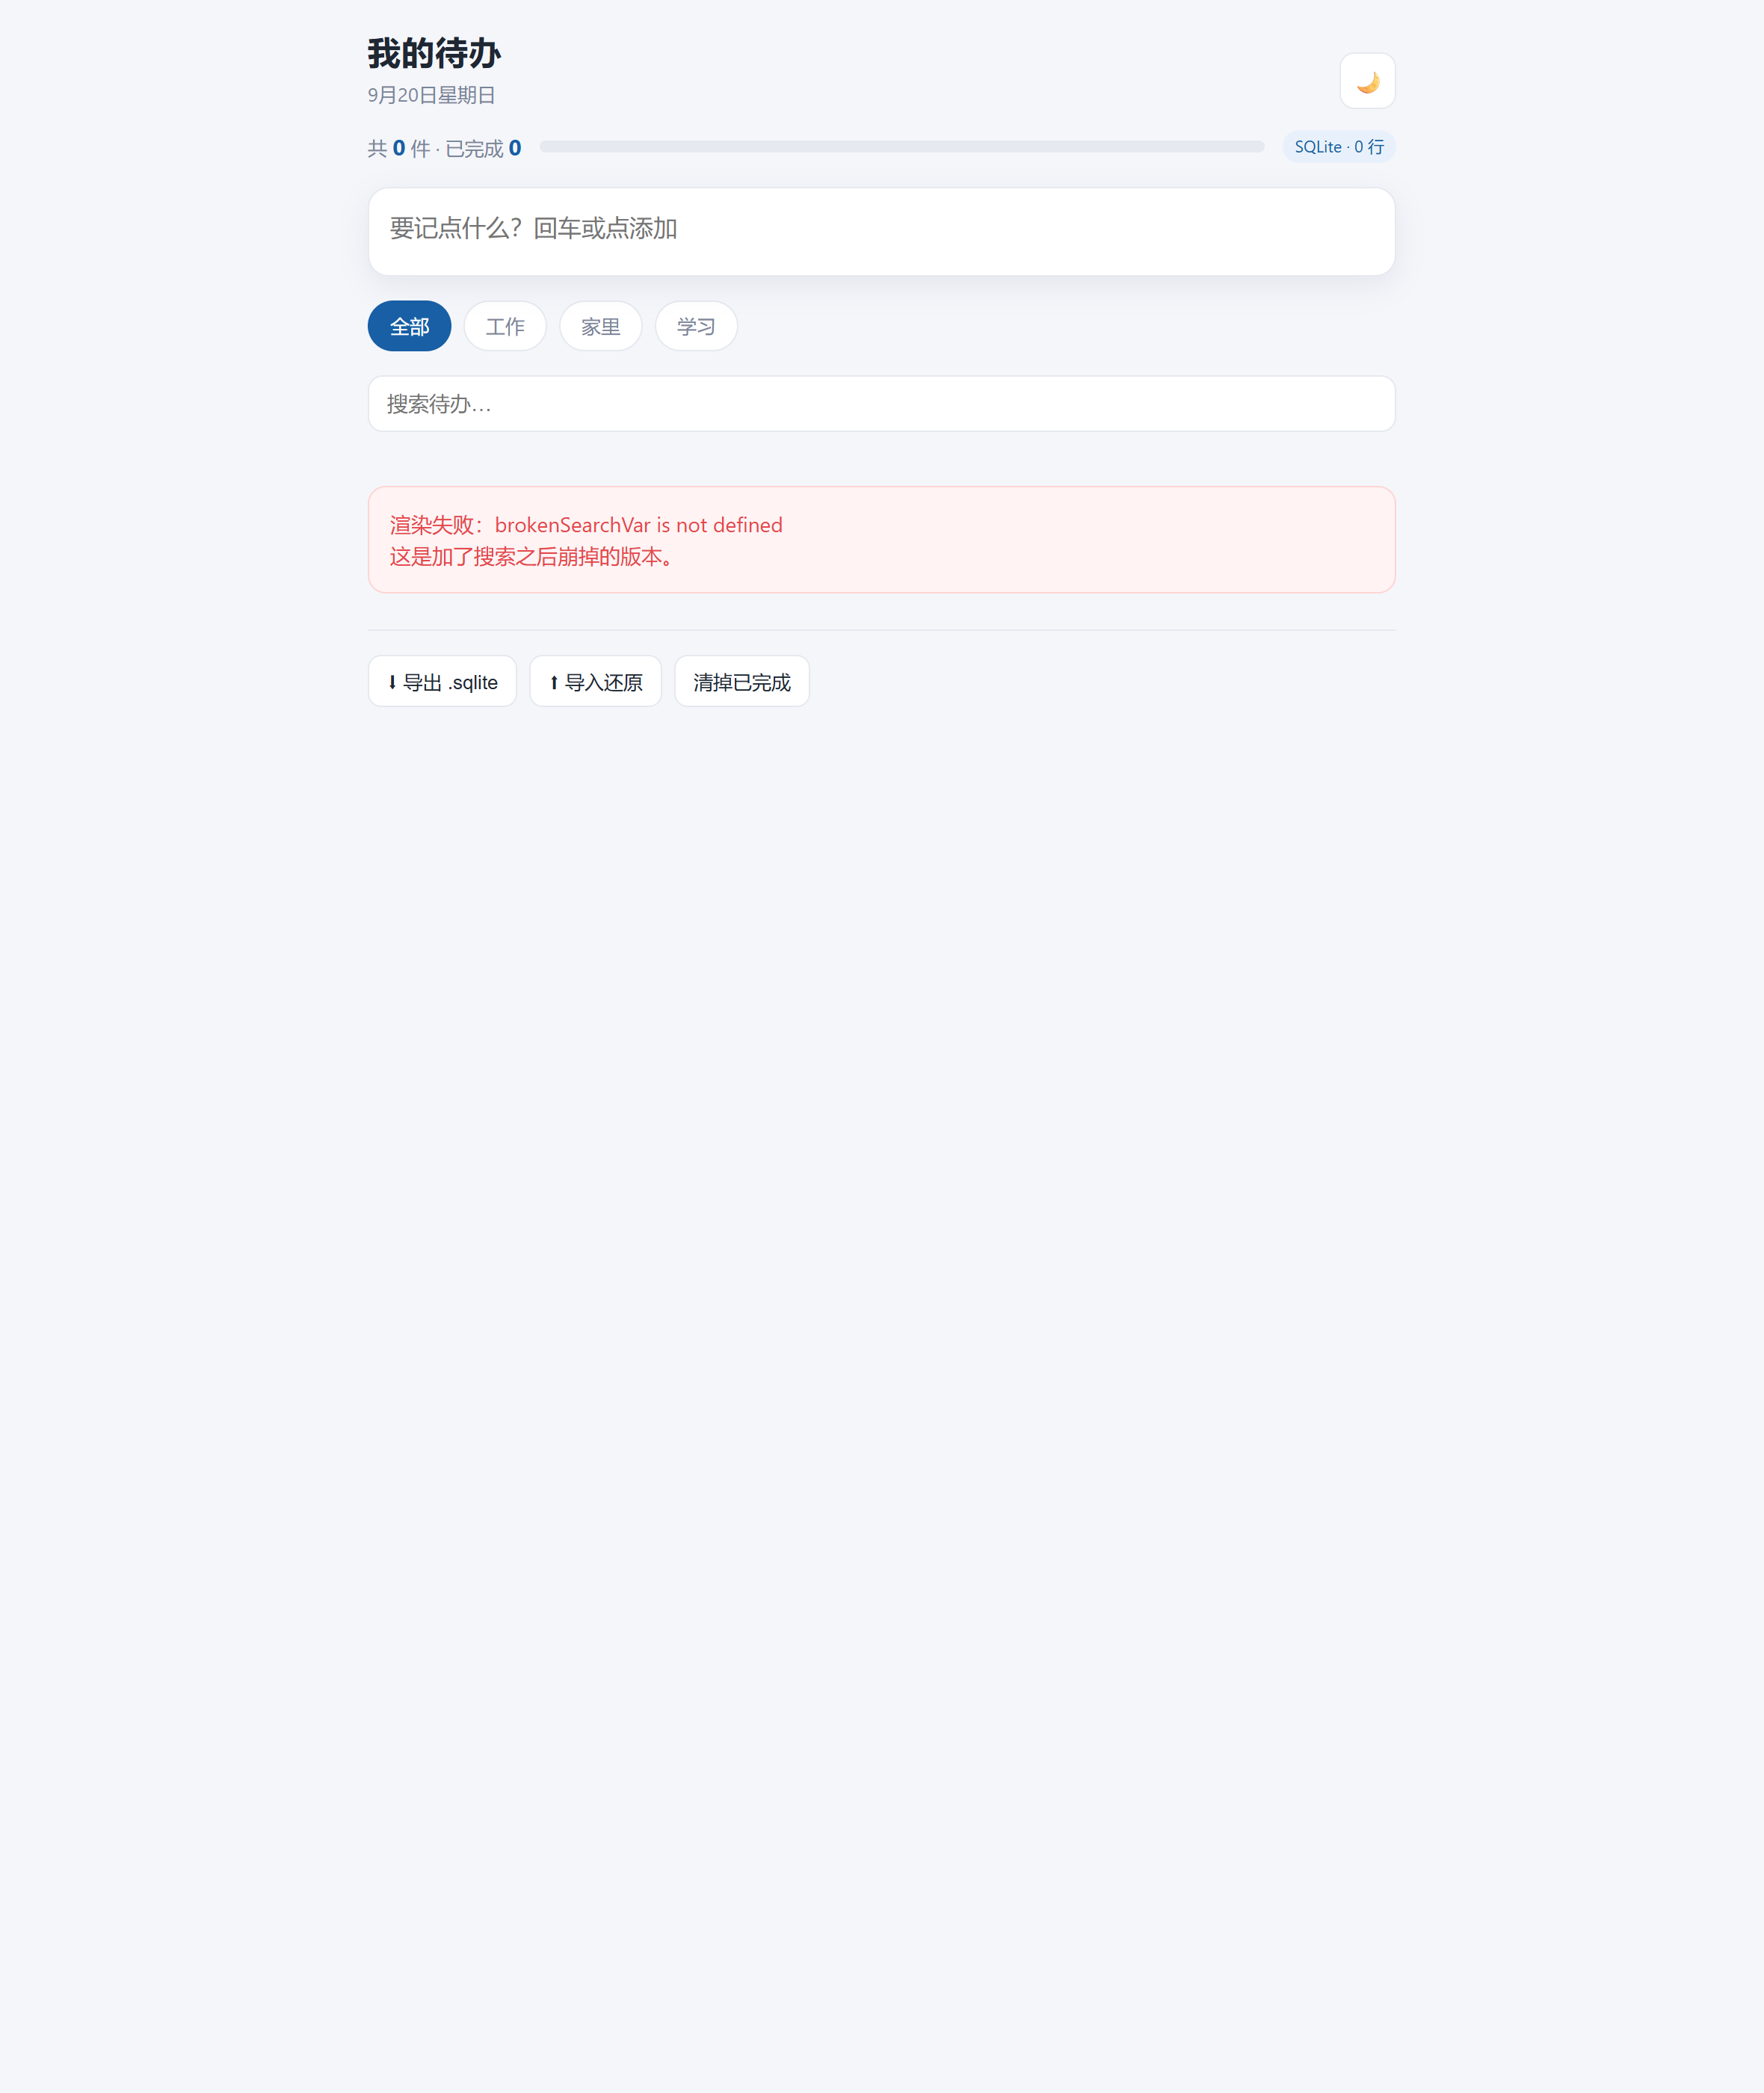
点分类标签,没反应。刷新,还是空白。
按第 02 篇教的路数,我 F12 打开控制台,同一行报错就在那,红色的。
第一次,这个东西在我手里变成了一堆我看不懂的故障。八年运维,我看过的报错没有一万也有八千,但那些都是我熟悉的世界里的报错。这行英文错误我不认识,那个文件里的代码我读不懂——我在自己的故障现场里是个外人。
但也就是几秒钟的事,职业本能接管了。排障流程是通用的,跟什么技术栈没关系。我按公司故障处理手册的节奏,一步步来。
第一步:定影响范围(30 秒)
问三个问题:数据坏没坏?坏的只有这一个页面吗?有没有别的入口能确认?
- 数据坏没坏:这事我心里有底——数据在 SQLite 里,不在页面里。页面崩是"显示层"的事,数据库文件本体不会因为一个 JS 报错就损坏。为了保险,我用浏览器把当前库又导出了一次,桌面多了一份
.sqlite。30 秒,数据安全确认 - 别的入口:没有,就一个页面
结论:显示层故障,数据无损,影响范围一个页面。这个结论让我心态稳了——最坏情况也就是回退。
第二步:回退预案(1 分钟)
运维的信仰:先恢复,再排障。但这里我做了个判断:故障的是单机单文件、没有用户在用、丢的最多是几分钟——这不是生产事故,是开发环境故障。开发环境可以先排障,不必抢回退。
但我照样把回退预案摆在了手边:
- 代码备份:让 WorkBuddy 改文件前会保留历史版本(它有版本记录),真不行让它退回上一版
- 数据备份:桌面上刚导出的
.sqlite,天塌了数据也在
这里说一句给同行的:这个应用最舒服的一点,是代码和数据是分离的。index.html 坏到亲妈都不认识,把文件删了重来,把 .sqlite 导回去,30 条待办原地满血。这个架构在运维世界里叫"无状态前端 + 独立存储",是祖传的好架构。
第三步:带证据报修(关键一步)
排障。我给 WorkBuddy 发的消息,原样贴出来:
你刚才的修改把页面改坏了。信息如下:
- 现象:列表区域完全空白,分类标签点击无响应
- 报错原文(控制台和控制台顶部红条一致):
ReferenceError: brokenSearchVar is not defined- 复现步骤:打开页面即复现,无需任何操作
- 我的判断:像是搜索功能用到了一个没定义的变量,但我不会改
先别急着改代码。先告诉我:这个报错的原因是什么?你觉得要怎么修?我确认了思路你再动手。
四个信息 + 一个"先说原因再动手",这就是带证据报修模板。跟给值班同事转事故一个写法:现象、报错原文、复现步骤、你的初步判断,一样别少。
"报错原文一字不改"是重点。我自己看不懂这行英文,但看得懂不等于要翻译——转述故障信息时自行"加工",是排障的大忌(这在运维世界有血泪教训:转述者觉得"大概不重要"漏掉的那半行,往往就是根因)。AI 读原文的判断力比我强得多,我别替它做减法。
"先说原因再动手"是另一道保险。如果它连原因都说错,那它接下去的修改大概率是瞎修。让它先复述病因,我虽然看不懂代码,看得懂逻辑——病因说得通不通,跟读故障报告是一个判断法。
它的回复很老实:搜索过滤的代码里引用了一个变量,那个变量在改动过程中被重命名了,但有一处引用没跟上——典型的改名不彻底。它解释了原因,说了修复思路(补上漏改的引用,并自查是否还有同类问题),然后动手。
修完,我验证:列表恢复,搜索框出现,输"巡检"——两条带"巡检"的待办被滤出来;清空,全部恢复。
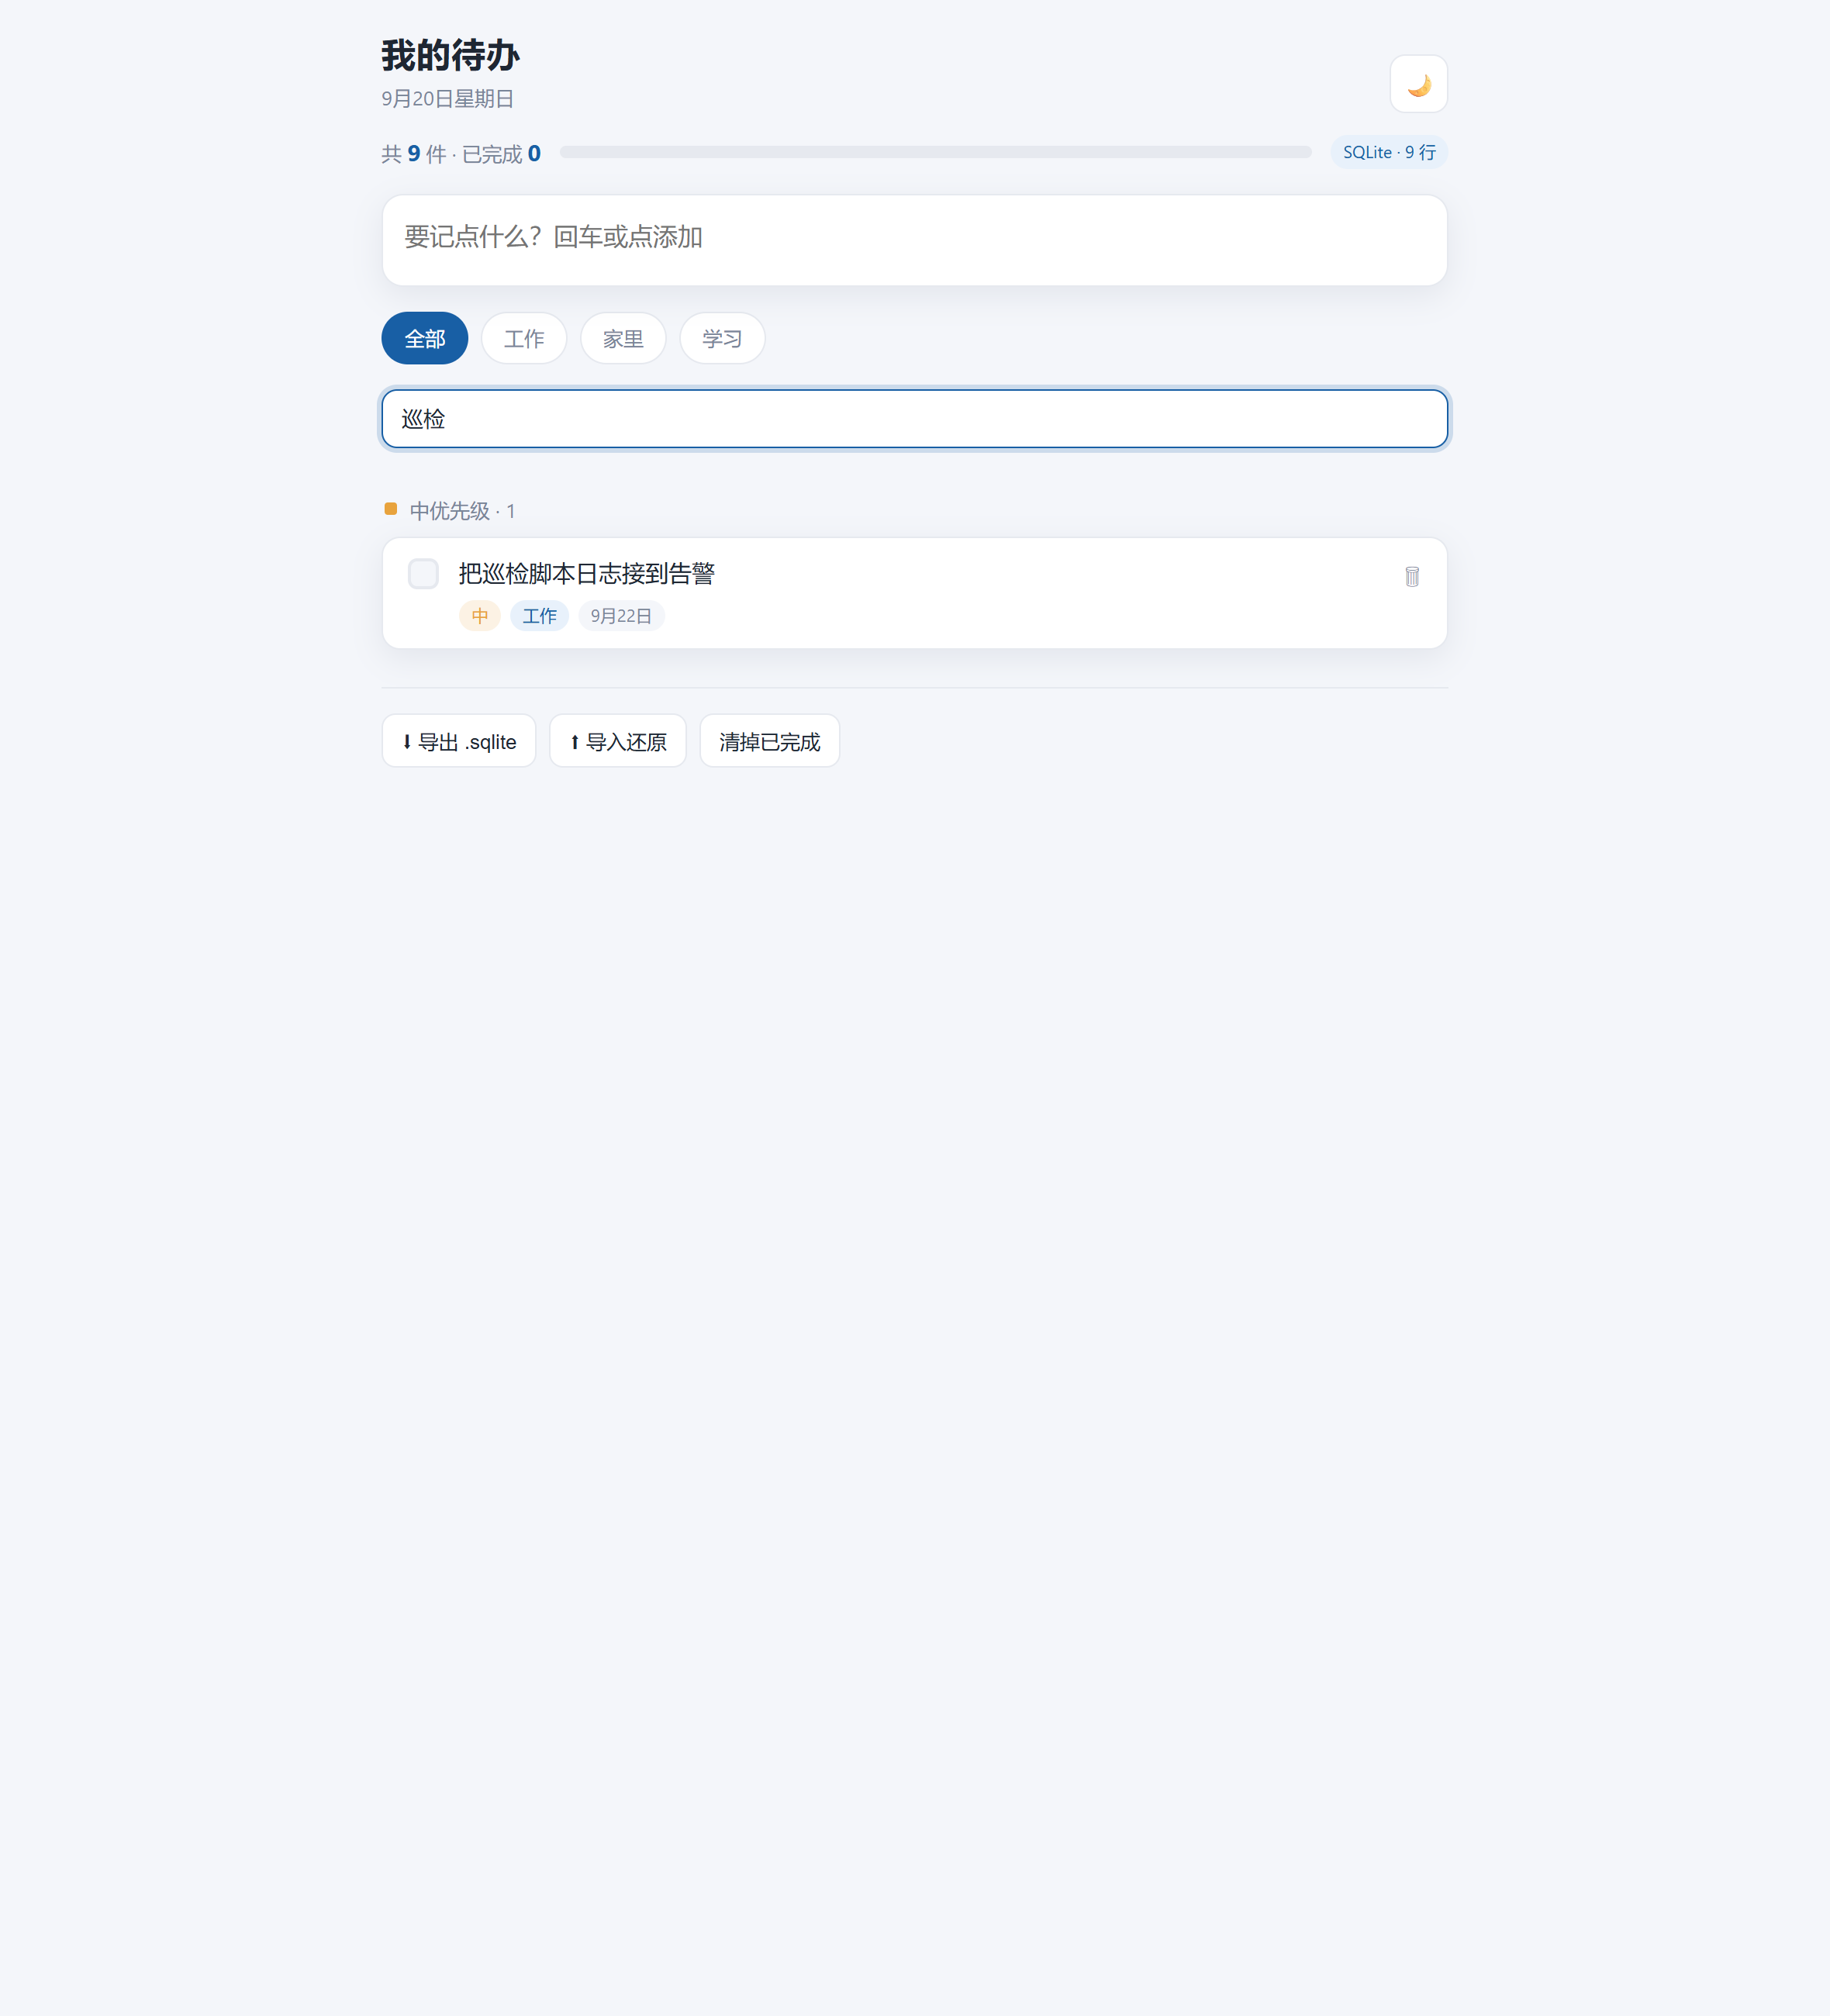
从头到尾,一轮沟通修复。没瞎猜、没反复试、没烧第二轮积分。
这次救火教会我的三件事
第一,AI 改代码的最大风险,不是写不出来,是把好的改坏。而且它改坏的时候不会提前打招呼。这个风险无法根除,只能管理——管理工具就是改前备份、改后验收这两件小事。
第二,报错不可怕,可怕的是不带证据地慌。"坏了坏了你快修"和"现象+报错原文+复现步骤",消耗的积分差三倍不止,修复成功率也差三倍不止。
第三,数据与界面分离的架构,是普通人做应用的安全气囊。这也是我当初死磕 SQLite 的意外红利:那次退回黑盒重做,本来只是出于数据洁癖,结果在这次救火里,"数据无损"这个结论让我从慌乱到冷静只花了 30 秒。
还有个 uncomfortable 的实话也得说:它改崩,我完全没法预防。我能做的只有让"崩"的代价变小——备份在先、验收在后、报修有模板。这是和 AI 协作做东西的常态:你没法指望它不出事故,你只能让自己永远有能力恢复。这话听着耳熟?对,运维的世界从来就是这么过的。
下一篇预告
功能、颜值、抗揍能力都齐了。这个应用还欠最后一块:它能不能告诉我"我这周干得怎么样"?
下一篇加完成率统计和导出,顺便让 WorkBuddy 拿我导出的数据库,给我做了一张周报图。数据再打一份工的事,下一篇见。


